32GB Mac mini 6 跑 125B 大模型:一次失败的小牛拉大车尝试
项目简介
Strata 是什么
Strata 是一个专注于大语言模型推理效率的项目,其核心思路是在消费级硬件上运行超大参数模型。传统观念认为,运行一个 125B 参数的模型需要至少 125GB 以上的显存/内存,而 Strata 打破了这个限制。
strata-mlx:Apple Silicon 专用推理引擎
strata-mlx 是 Strata 项目针对 Apple Silicon(M 系列芯片)开发的推理引擎,专门用于运行 Qwen3.8-Flash-Next 125B MoE 模型。该模型采用 MoE(Mixture of Experts,混合专家)架构,总参数量 125B,但每个 token 仅激活约 20B 参数。
核心技术特点
- GGUF 量化:支持 Q2_0(66 GB 双分片)和 IQ3_S(84 GB)等极低比特量化格式
- Metal 原生内核:直接从 GGUF 文件的 block 数据进行计算,无需先加载到 MLX 数组
- MTP 推测解码:Multi-Token Prediction 草稿头,7 个草稿 token + 验证,显著提升生成速度
- SSD 卸载:超出内存的专家参数按需从 SSD 读取,实现”小内存跑大模型”
- Range 请求获取 MTP:草稿头的 31 个张量(4.9 GB)通过 HTTP Range 请求从原始 BF16 检查点中提取,无需下载完整的 360 GB 模型
内存需求表
| Mac 内存 | Q2_0(磁盘 66 GB) | IQ3_S(磁盘 84 GB) |
|---|---|---|
| 16 GB | 9% 专家在内存 | 内存不足 |
| 24 GB | 34% 专家在内存 | 18% 专家在内存 |
| 32 GB | 59% 专家在内存 | 35% 专家在内存 |
| 36 GB | 72% 专家在内存 | 44% 专家在内存 |
| 48 GB | 全部,余 1.3 GB | 69% 专家在内存 |
| 64 GB | 全部 | 全部,差 2.1 GB |
| 96 GB+ | 全部 | 全部 |
“全部”指所有专家都在内存中,对应 README 中标注的实测速度(M4 Max 128GB 上 68-111 tok/s)。当只有部分专家在内存时,其余由 SSD 按需读取,速度大幅下降。
部署过程
环境
- Apple Silicon Mac,32GB 内存
- Python 3.12 + uv 包管理器
- macOS 27
安装与下载
1 | git clone https://github.com/yibie/strata-mlx && cd strata-mlx |
模型文件约 66 GB(Q2_0 量化),两个分片从 HuggingFace 下载(耗时约 4 小时,多次断点续传):
1 | https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF |
- 分片 1:37.6 GB,SHA-256 校验通过
- 分片 2:28.8 GB,SHA-256 校验通过
MTP 草稿头通过 Range 请求获取,31 个张量(4.9 GB),每个都经过 SHA-256 校验:
1 | python tools/mtp_fetch.py fetch --out ~/.cache/strata-mlx/mtp |
引擎启动
1 | ./strata-mlx --serve --native <分片1路径> --mtp ~/.cache/strata-mlx/mtp --machine-memory 32 |
实测启动日志:
1 | strata-mlx: 14834 experts (20.5 GB) read ahead in 13.9 s |
启动耗时 126 秒(比 README 标注的 23 秒慢很多,差异来自 SSD 预读专家的 13.9 秒和内核编译时间)。14834 个专家中 59% 驻留内存(20.5 GB),其余 41% 由 SSD 按需读取。
交互测试:能跑,但不好用
聊天脚本
strata-mlx 只提供行协议(stdin/stdout),没有 HTTP 或 OpenAI 兼容接口。写了一个 Python 聊天脚本,通过子进程管道与引擎交互,用 transformers 的 tokenizer 做文本到 token ID 的转换。
脚本遇到了一个坑:引擎在返回 T <id> 之前会先发 RESUME 和 PP 行,如果不对这些行做特殊处理,脚本会误判为异常响应而提前退出,导致输出为空。修复后脚本可以正常工作。
实际对话体验
启动引擎后发送 “hi”,引擎确实产生了响应:
1 | 你: hi |
这是模型的 <think> 标签内的思考过程——它在推理,但输出非常慢。在 32GB 机器上,41% 的专家需要从 SSD 读取,每次推理步骤都伴随着大量的 SSD I/O。
为什么说是”失败”的
| 指标 | 32GB 实测 | 128GB 参考(README) | 实用门槛 |
|---|---|---|---|
| 启动时间 | 126 秒 | ~23 秒 | < 10 秒 |
| 生成速度 | 极慢(SSD 瓶颈) | 68-111 tok/s | > 15 tok/s |
| 交互延迟 | 每句等待数十秒 | 即时感 | < 2 秒 |
| 内存余量 | 仅够系统勉强运行 | 充裕 | 留 4GB+ |
核心问题:32GB 只够放 59% 的专家。剩下的 41% 每次被请求时都要从 SSD 读取。MoE 模型的特点是每个 token 都要路由到不同的专家,这意味着几乎每次推理步骤都会触发 SSD 读取。理论上的 21-30 tok/s 在实际交互中因为上下文累积和 SSD 随机读取的开销,体感远低于此。
结论:技术上跑起来了,实际上无法用于日常对话。这不是”小马拉大车”,更像是”小牛拉大车”——牛确实能拉动,但走不动。
性能数据(自动化测试)
在引擎刚启动、上下文为空时,用自动化脚本发送短 prompt 测得的数据:
| 指标 | 32GB Mac 实测 | 128GB M4 Max(参考) |
|---|---|---|
| 生成速度(短 prompt) | 21.5 - 29.8 tok/s | 68 - 111 tok/s |
| Prompt 处理速度 | ~220K tok/s | - |
| 启动时间 | 126 秒 | ~23 秒 |
| 内存占用 | 24.9 GiB 权重 | - |
| 长上下文 | 测试到 64K 稳定 | 131K |
短 prompt 的速度数字看起来还行,但交互体验是另一回事——上下文一旦累积,SSD 读取量急剧增加,速度断崖式下降。
与 ollama qwen3.8:27b-mlx 对比
| 维度 | Qwen3.8-Flash 125B MoE(32GB) | Qwen3-27B(ollama,32GB) |
|---|---|---|
| 总参数量 | 125B(激活 ~20B) | 27B |
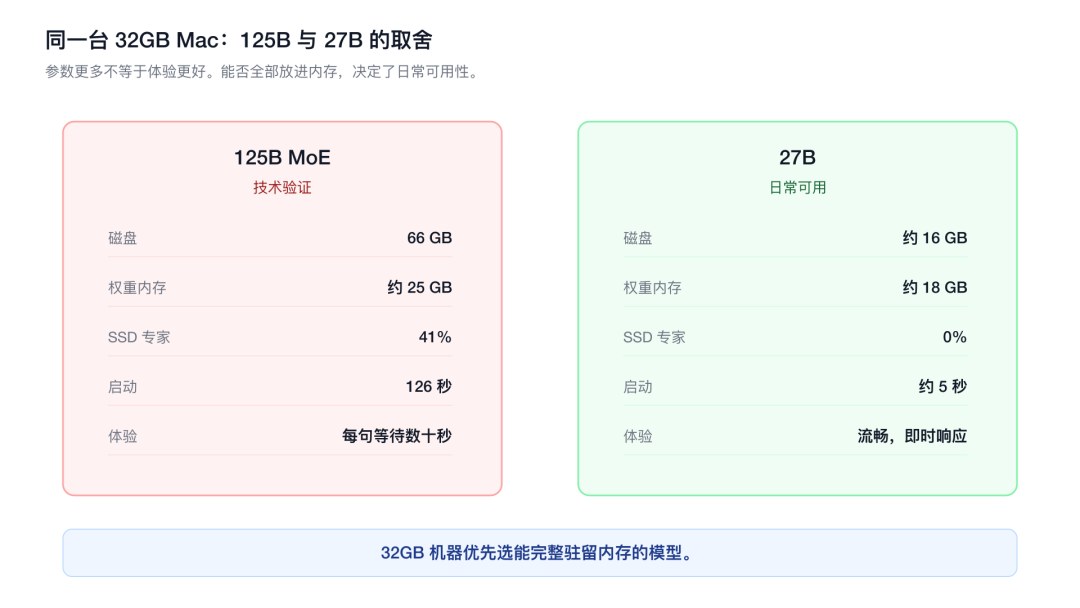
| 磁盘占用 | 66 GB | ~16 GB |
| 内存占用 | ~25 GB(41% 靠 SSD) | ~18 GB(全部在内存) |
| 启动时间 | 126 秒 | ~5 秒 |
| 交互体验 | 每句等数十秒 | 流畅,即时响应 |
| 输出质量 | 有 think 标签,推理更深 | 格式更好,回答更完整 |
| 长上下文 | 理论 131K | 32K-128K |
| 实用性 | 技术验证,不实用 | 日常可用 |
27B 在 32GB 机器上是更好的选择:全部参数放得进内存,不需要 SSD 交换,启动快,响应流畅。125B 模型虽然参数更多、理论能力更强,但在内存不够的情况下,SSD 交换的代价太大。
如何访问和测试
方式一:本地部署 125B MoE(需要 48GB+ 内存才实用)
1 | git clone https://github.com/yibie/strata-mlx && cd strata-mlx |
32GB 能跑但不好用;48GB 全部专家入内存,才能达到 README 标注的实用速度。
方式二:ollama 运行 27B(32GB 机器的最佳选择)
1 | ollama run qwen3.8:27b-mlx |
自带 OpenAI 兼容 API:
1 | curl http://localhost:11434/v1/chat/completions \ |
方式三:HuggingFace 原始模型
- GGUF 量化版:ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- BF16 原始检查点:Qwen/Qwen3.8-Flash-Next(360 GB)
总结
strata-mlx 是一个技术上令人印象深刻的项目——它确实让 125B 参数的 MoE 模型在 32GB Mac 上跑了起来。但”跑起来”和”能用”之间隔着巨大的鸿沟。59% 的专家在内存、41% 靠 SSD 交换的配置,让实际交互体验远低于预期。
真正的”小马拉大车”需要 48GB 以上的内存,让所有专家都留在内存里。在那之前,32GB 机器上的 125B 模型更像是一个技术演示——证明了路径可行,但还不是一个实用的工具。