给 Pi 加个工具抽屉,Mac mini6 上千问 27B 也跑得动智能体
我在本地装了千问 3.8 的 27B 量化版,一直想让它真正干点活,而不只是聊天。本地跑智能体的好处很实在:不用联网、不按 token 付费、材料不用出门。
挑来挑去用了 Pi。它是一个开源的终端编码智能体,命令 pi,带读文件、跑命令、改代码这几个基础工具,本身很轻,还能自己加扩展和 MCP 服务。
刚装好那几天很顺,等我把它当主力用、扩展一个个加上去,就撞墙了:模型每回答一轮,都要先把所有工具的说明书读一遍,工具越多读得越久。本地模型的上下文窗口就那么大,堆到一定程度不是慢,是直接撑破。
这篇讲我为这件事做的改造、改完之后的同机对比测试,以及怎么装来用。项目已经开源在 GitHub:github.com/fanzhh/pi-tool-ladder。
问题出在工具的说明书上
每个工具都要带一份说明书给模型看:名字、干什么用、要哪些参数。这份说明书不是只在用到时才读,而是每轮都要重读。三组数字能说明后果:
我平时的配置有 29 个工具,说明书合起来 62,464 个字符,约 1.56 万 token,跑一句话等 169.8 秒
我把工具加到 189 个(模拟以后扩展越装越多的样子),说明书变成 19.7 万字符,整条提示词 5.13 万 token,等 502.5 秒
读入速度是每秒 180 到 200 token,所以 5 万 token 的提示词注定要读好几分钟
第二组数字还有更要命的地方。我给本地模型开的是 32K 上下文窗口,5.13 万 token 的提示词根本放不下,实际是截断后才喂进去的。也就是说,工具堆到一定程度,模型看到的上下文是残缺的,回答自然不靠谱。
还有一条是我踩了才知道的:工具清单变了,整条提示词的缓存就作废。换一套没用过的工具,得从第一个字重新算;换回用过的,反而几乎不花时间。所以那种”每轮按任务临时挑一套工具”的想法听着聪明,实际会更慢。
改造思路:三层抽屉
我的做法是把工具当成抽屉里的说明书:每轮只把当下要用的那几页摆到桌面上,其余锁进抽屉,但留一个随时能开的抽屉口。
第一层,按会话分大类。文件与代码、联网检索、MCP 外部服务、子智能体和协作,再加一个通用兜底。判定默认用关键词,不调模型,一次判定 17 微秒。判定结果在同一个会话里粘住不换,因为换类别要重算提示词,来回横跳比不分类更慢。
后来我又试了让本地的小模型(System One)来做这个判定,同一批 16 条提示对比:关键词 15 条全对(单次 17 微秒);小模型单独用 13 条对(热态约 38 毫秒);改成”小模型置信度超过 0.5 才采信,否则回退关键词”之后又回到 15 条全对,其中 9 条真的用了小模型。它错的那两条,置信度分别只有 0.425 和 0.463,正好被这道门挡住。所以置信度门不是可选项,是敢接小模型的前提。
第二层,每个类别里只放一小撮。两道闸卡着:工具个数上限,和说明书字符总数上限。
第三层,也就是抽屉口。我多给模型两个小工具:一个查当前摆了什么、锁了多少;另一个能列出全部工具、按关键词搜、临时挂上或卸下,也能自己换类别。
再配三条不退让的规矩:
没归到任何类别的工具,一律不挂。以后新装扩展,它的工具自动落进”没归类”,不会自己挤进来
预算说了算。哪怕是我或模型点名要挂的工具,超出字符上限也挂不上
提示词发出去之前再筛一遍。实测确实有别的扩展会在我之后把工具塞回来,只在前面收一次不够
一轮对话里,工具是怎么被挂上、又是怎么被卸下的,看这张图:
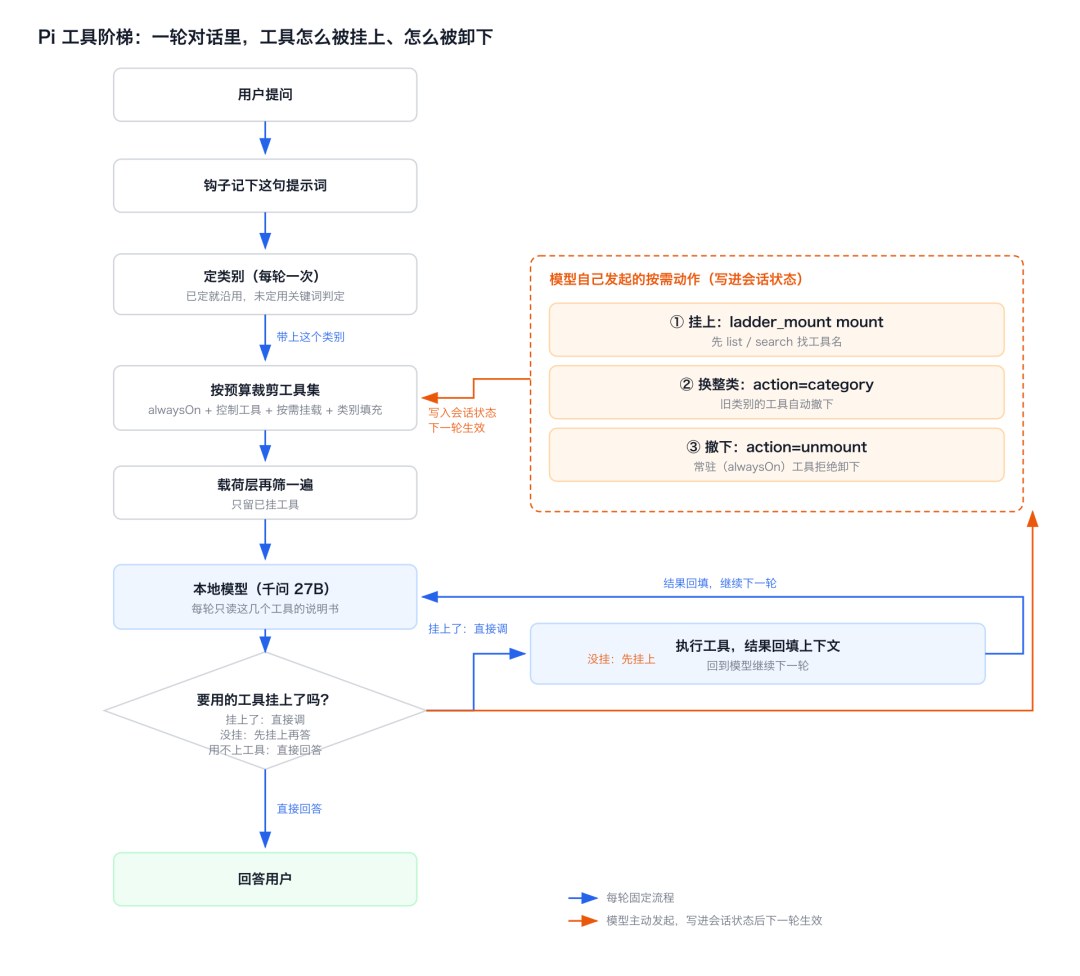
图 1:一轮对话里工具怎么被挂上、怎么被卸下
蓝色是每轮固定要走的流程,橙色是模型自己发起的按需动作。挂上、换整类、撤下这三件事都只写进会话状态,下一轮才生效。
改造路上翻的车
跑到一半,我自己把模型坑了一次。
测试时我故意让会话粘在”联网检索”类,然后改口让它改一个配置文件——那个改文件的工具压根没挂上。它自己调了一次按需挂载,把工具挂上,文件真的改了,改完还说明了一句”这个工具原本压在别的类别里”。
第二次我让它派一个子智能体干活。子智能体的说明书有 2.5 万个字符,超过我设的上限,按规矩永远挂不上。结果它连着调了 18 次挂载:反复挂上卸下,跑去代码沙箱里翻,又用搜索查别名,还想拿”等待子智能体结果”那个工具顶替,最后停下来问我:是把预算放宽,还是不用子智能体。
问题不在模型,在我的返回值。它每次挂载失败,我都只回一句”已完成”,它不知道自己为什么失败,于是换个姿势再试。
我改了三处:返回值写清楚谁没挂上、为什么(当前字符数和上限各是多少)、别再重试,以及还有哪几条路;常驻的核心工具不许被卸掉;让它自己能换类别。
同一个场景再测:调用从 18 次降到 3 次。它主动用了新加的换类别功能,发现还是装不下,就用已经挂着的读文件工具把活干完了,还补了一句”这个数不是子智能体给的,是我自己读的”。
给模型用的工具,失败时一定要说清原因。这是我这轮最大的收获。
对比测试:精简版和未精简版
改造完,最有说服力的验证就是拿两个版本、同一个本地模型、同一句话来跑。都在那台 32GB 内存的 Mac mini 上,都是我本地的千问 27B:
| 配置 | 工具总数 | 进提示词的工具 | 提示词体积 | 等待时间 |
|---|---|---|---|---|
| 未精简,平时配置 | 29 | 29 | 约 1.78 万 token | 169.8 秒 |
| 未精简,189 个工具 | 189 | 189 | 约 5.13 万 token | 502.5 秒 |
| 精简版,平时配置 | 36 | 7 | 约 2390 token | 73.1 秒 |
| 精简版,189 个工具 | 189 | 7 | 约 2390 token | 61.5 秒 |
几个读法:
工具从 29 个涨到 189 个,未精简那栏翻了 3 倍;精简版那两栏几乎没动,都在 2390 token 左右
平时配置是 169.8 秒降到 73.1 秒;189 工具那档是 502.5 秒降到 61.5 秒
秒数别当跑分看。四个配置是顺序跑的,本地只有一块推理槽,后跑的会受前一档影响;后两行提示词完全一样,差 11.6 秒属于正常波动。真正可信的是提示词体积那几列,那是确定性的
除了提速,我还跑了一遍功能回归:9 个用例、72 条断言,覆盖分类判定、会话内粘住不换、按需挂载、以及”点名挂一个大工具也不许顶破预算”,全部通过。
怎么装来用
项目在 GitHub,MIT 协议,直接拉下来:
1 | git clone https://github.com/fanzhh/pi-tool-ladder |
最后一行是在仓库目录里临时带上这个扩展跑一次,也可以换成完整路径。想常驻,就把它加进 ~/.pi/agent/settings.json 的扩展列表。
用起来只有两个命令:/ladder 看当前摆了什么工具、压下了多少;/cat fs(可换 web、mcp、agent、general)手动换类别。
三个最常调的旋钮在 ladder/config.default.json:工具个数上限、说明书字符上限、每个类别里放什么。也可以在每个项目里放一份 .pi-tool-ladder.json 覆盖默认值。
如果你只想先感受一下”工具多少到底差多少”,不用装扩展也行,Pi 自带工具白名单:
1 | pi --tools read,bash |
三条边界
第一,说明书超上限的工具,会话里拿不到。子智能体那种一个就 2.5 万字符的,在我 14000 的预算下永远挂不上。要么把预算调大,要么改用同类里更小的工具。这是取舍,不是故障。
第二,关键词判定不看语义,只数命中了几个词。有一句提示同时提到”网页”和”文件”,因为命中两个网页相关词、只命中一个文件相关词,判给了联网类;词数一样时,才轮到类别优先级决定。真需要另一类的工具,就靠模型自己按需挂上。
第三,我自己配置里写的工具顺序目前没生效。实现上是按工具注册顺序取,不是按我写的优先序列取,所以有个本该在高位的工具被挤出了类别。这是测试时发现的缺口。
结论
想在本地跑智能体,真正的门槛除了模型能力,还有每轮要重读的那一叠工具说明书。把它锁进抽屉、每轮只抽当下要用的几页,同一个本地千问 27B,提示词体积压掉 96%,等一句话的时间从 8 分半降到 1 分钟。
抽屉能成立靠三条规矩:没归类的不挂、预算不让步、发出去之前再筛一次。至于判错类别,让模型自己拿抽屉口补救就行,前提是失败时你得把原因说清楚。
今天就能试的:拿 pi --tools read,bash 和你平时的配置各跑一句话,先量一下差距,再决定要不要装扩展。