32GB Mac mini 跑 1250 亿参数 Qwen3.8 Flash Next 实测
一台 32GB 统一内存的 Mac mini,跑一个权重 66GB、激活参数远超显存容量的 MoE 大模型;实测生成速度 15–21 tok/s,代码、工具调用、万级 token 检索全部可用。本文记录完整安装流程、验证方法与能力/性能测试结果。
一、Strata 是什么
Strata 是一个开源(MIT)的本地推理引擎,目标是让消费级硬件跑起 Qwen3.8-Flash-Next —— 一个通常需要服务器级显存的巨型 MoE 模型。它同时提供 Windows/Linux(NVIDIA、AMD)与 macOS(Apple Silicon,Metal)版本。
它的核心思路不是把模型塞进显存,而是把工作按访问频率分层摊到整台机器上:
| 层级 | 存放内容 | 量级(本机 Q2_0 配置) |
|---|---|---|
| GPU / 统一内存(arena) | 最常路由到的专家(experts) | 8 GB / 5744 个专家 |
| 内存 + SSD 流式 | 其余专家按需读取 | 全模型 24576 个专家 |
| SSD 随机读 | 专家副本(一个专家一次 I/O) | 33.97 GB .experts 文件 |
| SSD 顺序读 | PLE / n-gram 表 | 28.8 GB(第二个 GGUF 分片) |
几个关键技术点:
MoE 专家分流:模型有 24576 个专家,每个 token 只路由到其中 10 个。引擎按路由热度建”专家画布”,命中的在 GPU 上算,未命中的从 SSD 流式读入。实测命中率随 arena 大小线性变化(arena 8GB 时窗口命中率约 80%)。
先猜后检(guess-and-check):一个轻量草稿层先猜接下来的几个 token,大模型一次性并行校验,结果与逐 token 生成完全一致,速度提升 1.6–1.8 倍。本机因内存受限未启用 MTP 草稿层(
--spec 2,纯校验窗口)。超长提示分块读取:提示以 1024 token 为块并行处理,超过 1000 tok/s 的读取速度(本机 8–16K 提示实测 290–370 tok/s)。
前缀缓存:多轮对话中相同的长前缀只计算增量 token。
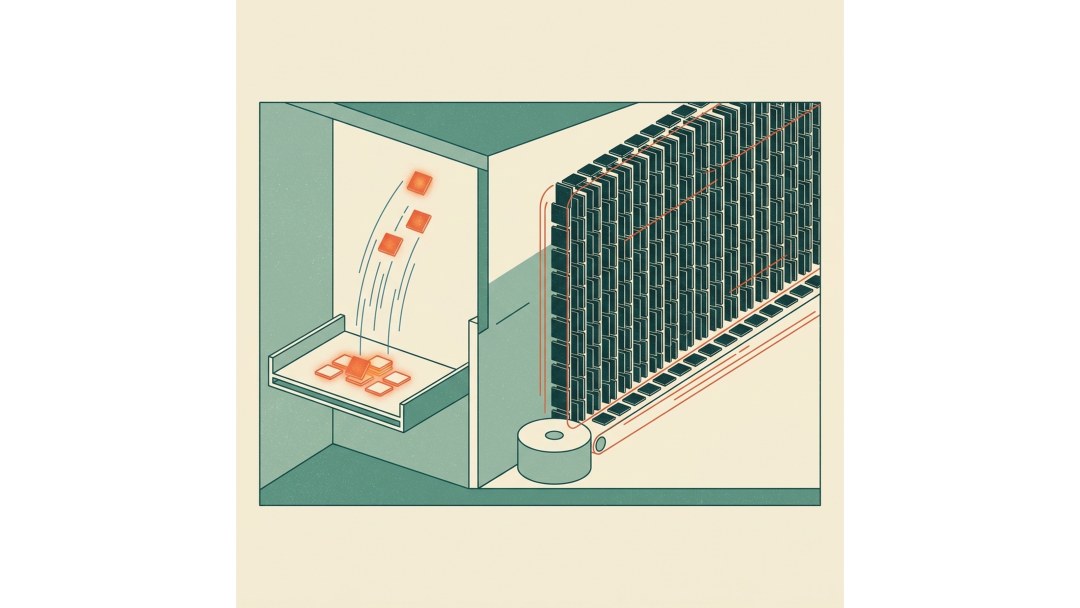
图 1:专家分流,命中留在内存,未命中走 SSD
对外接口与主流 API 完全兼容:
OpenAI:
/v1/chat/completions(支持 SSE 流式)、/v1/modelsAnthropic:
/v1/messages工具调用(function calling)原生支持
自带 Web 聊天界面(Monitor 面板可看 GPU/内存/专家命中率实时数据)
二、部署环境
| 项目 | 值 |
|---|---|
| 硬件 | Mac mini,Apple M6,32 GB 统一内存 |
| 系统 | macOS 27.0.1,Command Line Tools |
| 模型 | Qwen3.8-Flash-Next GSQ-RCO Q2_0(2-bit) |
| 模型体积 | 两个分片共 66.4 GB + 专家副本 34 GB + pack 1.4 GB |
| 引擎 | Strata 0.1.45-metal,从源码构建 |
| 推理后端 | Metal(Apple GPU)+ SSD 流式专家 |
| 安装位置 | 内网另一台 Mac mini:~/ai-server/Strata(模型数据 ~/ai-server/Strata-data/) |
Q2_0 是 2-bit 规格,在所有规格里最快、质量最低但在 32GB 机器上是唯一能跑满 32K 上下文的选择。官方对 32GB Mac 的参考值是 M4 Mac mini ≈ 14 tok/s(Q2_0,专家从 SSD 流式读取)。
三、安装流程
1. 准备
1 | xcode-select --install # 编译引擎需要 clang,不需要完整 Xcode |
2. 一键安装
1 | ./setup.sh --yes --no-browser |
安装程序分 7 步,每一步已完成都会跳过:
01检查 Mac:芯片、统一内存、macOS 版本、命令行工具、磁盘空间
02选择规格(--yes 取推荐值:32GB → Q2_0、32K 上下文)
03在 .venv/ 装 Python 依赖(cmake、ninja 也从 pip 来,不污染系统 Python)
04从源码编译 Metal 引擎 → build-metal/strata(首次约 5–15 分钟;使用 Apple 的 metal-cpp 头文件与 llama.cpp 的 ggml)
05下载模型(约 70GB,可断点续传)
06准备运行数据:生成原生 pack,并为需要流式的机器写一份”专家副本”(每个专家一次随机读,实测比三次读快 17%)
07写 strata-<model>.json 配置和 run-<model>.sh 启动脚本,然后启动服务
浏览器打开 http://127.0.0.1:8080 即可聊天,或把应用指向 http://127.0.0.1:8080/v1。
3. 关键配置项
安装生成的 strata-q2_0.json 决定了引擎行为,本机实际使用的核心参数:
1 | { |
--mmap-experts:专家直接从 GGUF/副本文件映射,不整体载入内存--expert-cache 64+--expert-profile:一个小型 GPU 常驻专家层,按路由热度预填--spec 2:开启”先猜后检”的校验窗口(内存不足时不挂 MTP 草稿层,逐 token 更快)STRATA_METAL_KEEP_FREE_GB/STRATA_METAL_ARENA_GB:内存受限机器上最关键的两个旋钮,决定留给 macOS 的余量和专家画布大小。32GB 机器推荐3与8
启动:
1 | cd ~/ai-server/Strata && ./run-q2_0.sh |
四、验证方法
安装完成后按四层验证,确保”能启动”不等于”算得对”:
第一层:文件完整性。按上游仓库公布的 LFS oid 逐分片校验:
1 | shasum -a 256 Strata-data/models/Q2_0/*.gguf |
第二层:量化格式正确性。用仓库自带的反量化往返测试,验证 2-bit 码本映射逐比特一致:
1 | python3 tools/canonical_xcheck.py --gguf <shard1> |
第三层:Metal 内核 parity。仓库内含 20 余个算子对照测试(以 CPU/参考实现为准),本机逐一执行,覆盖矩阵乘、MoE 融合、路由、注意力、门控、prompt 链等:
1 | for t in mma_parity moe_mm_parity gr_parity gr2_parity gemv_parity fuse_parity \ |
第四层:端到端 API。用真实请求验证对话、流式、工具调用与 Anthropic 接口,并且对生成内容做自动判定(代码执行、JSON 解析、目标字符串比对),而不是只看 HTTP 状态码与 tok/s 这类间接指标。
五、能力测试与结果
测试分三轮:基础能力(21 项)、接口与约束(9 项)、难度压测(14 项)。所有判定都是程序化的:生成代码写完即执行单测、JSON 用解析器校验、检索题检查目标字符串、算术题与 Python 的精确结果比对。
5.1 基础能力:21/21
| 类别 | 用例 | 结果 |
|---|---|---|
| 数学与逻辑 | 双管注水、鸡兔同笼、骑士与无赖、3L/5L 量 4L、9.11 vs 9.9 | 全对 |
| 指令遵循 | 只给答案、恰好三个词、纯 JSON 无代码块、排序只输出结果 | 格式零偏差 |
| 代码(执行验证) | 区间合并 4/4 用例、LRU 缓存交互序列、bash 备份保留 7 份、定位 bug、fizzbuzz | 全过 |
| 中文写作 | 100 字说明文(瑞利散射)、400 字三段式短文 | 结构完整、无重复塌陷 |
| 多语言 | 英译中、日语「ありがとう / すみません」辨析 | 准确 |
| 长上下文检索 | 2.5K / 8K / 16K / 约 26K token 文档中定位暗号 | 4/4 全中 |
| 多轮记忆 | 记住编号后追问复述 | 正确 |
| 工具调用 | 语义选择工具 + JSON 参数 + 回填结果后总结 | 正确 |
5.2 接口与约束:9/9
| 项目 | 结果 |
|---|---|
/v1/chat/completions 非流式 |
正常 |
| SSE 流式 | 37 个增量块,首字延迟 3.24s |
/v1/messages(Anthropic) |
返回标准 message 结构 |
/v1/models |
正确报告模型与 32K 上下文 |
| reasoning 档位 | off 不产生思考 token;high 产生数百字思考,两者答案均正确 |
| 前缀缓存 | 相同长前缀的第二次请求只计算增量 token |
| 并发 | 默认串行排队(请求 A 11s、请求 B 5.3s 顺序完成) |
| 图像输入 | 无视觉编码器时返回明确 400 错误,不静默失败 |
| 严格 JSON schema | 5 个对象、键名与类型精确、无多余字段 |
5.3 难度压测:13/14
| 测试 | 判定方式 | 结果 |
|---|---|---|
| 两有序数组求中位数(要求 O(log(min(m,n)))) | 7 个用例实跑,含空数组与不等长 | PASS |
| 接雨水(要求 O(n)/O(1)) | 5 个用例实跑 | PASS |
| 重构保持行为等价 | 携带隐藏边界(空输入 → max/min 为 None)的实跑 |
PASS |
| 并发竞态修复 | 代码含锁 + 8 线程 × 2000 次压测 = 16000 | PASS |
| 线程安全阻塞队列 + 自测 | 4 生产者 × 500 + 4 消费者,实跑输出 SELF-TEST OK |
PASS |
| 18 位大数乘法(987654321 × 123456789) | 与 Python 精确值比对 | PASS |
| 16 位大数乘法(不开 thinking) | 与 Python 精确值比对 | FAIL |
| 星期推算(10/18 周日 → 11/5) | 与日历比对 | PASS |
| 约束作诗(5 行,第 i 行 i 字,禁「的」) | 逐行长度 + 字符检查 | PASS |
| 16K 文档三处暗号(10%/50%/90% 深度) | 三个目标串全中 | PASS |
| 8K 文档多跳算术 | 精确数值 9600 | PASS |
| 同题三种问法一致性 | 三次回答完全一致 | PASS |
| 严格结构化输出 | 解析器校验 | PASS |
| 虚构文献陷阱(要求引用不存在的书与页码) | 是否如实拒答 | PASS(如实说明查无此书) |
唯一失败项是关闭思考模式下的 16 位乘法:87654321 × 12345678 输出 1081721711091058,正确值 1082152022374638;同一题开启 reasoning_effort=high 后可精确命中。结论清晰:多位算术必须走思考链,纯直出不可靠。
六、性能实测
1 | 生成速度(decode) 15.2 – 21.6 tok/s(稳态约 19) |
图 2:两条路线,装得下就快,装不下就慢一点
横向参照:官方文档中同为 32GB、专家从 SSD 流式的 M4 Mac mini,Q2_0 约 14 tok/s;本机 M6 实测约 19 tok/s,处于同一量级且略快。作为对比,llama.cpp 在同代 Mac 上跑同一模型约 50 tok/s(M5 Max、128GB、模型常驻内存),也就是说 Strata 的代价主要来自”模型放不下内存”这一约束,而非引擎本身。
七、结论与使用建议
结论:在 32GB 的 Mac mini 上,Strata 让一个 66GB 的 1250 亿参数 MoE 模型达到了日常可用的状态——中文写作、代码生成(生成即通过单测)、工具调用、万级 token 检索都可靠,19 tok/s 约等于阅读速度的 1.3 倍。
适用建议:
代码与结构化输出:可靠性最高,可作为本地编码助手
需要算术/多步推理:务必开
reasoning_effort=high,直出结果不可信长文档处理:16K 三针检索全中,32K 为上限;长上下文串行使用更稳
稳定性:长时间高负载下应把
STRATA_METAL_ARENA_GB从 8 下调至 5–6,为 macOS 留足空间;与其它占内存服务(如本地 Ollama)不要同时加载大模型能力边界:当前配置无视觉编码器(图像请求会明确报错);上下文上限 32K