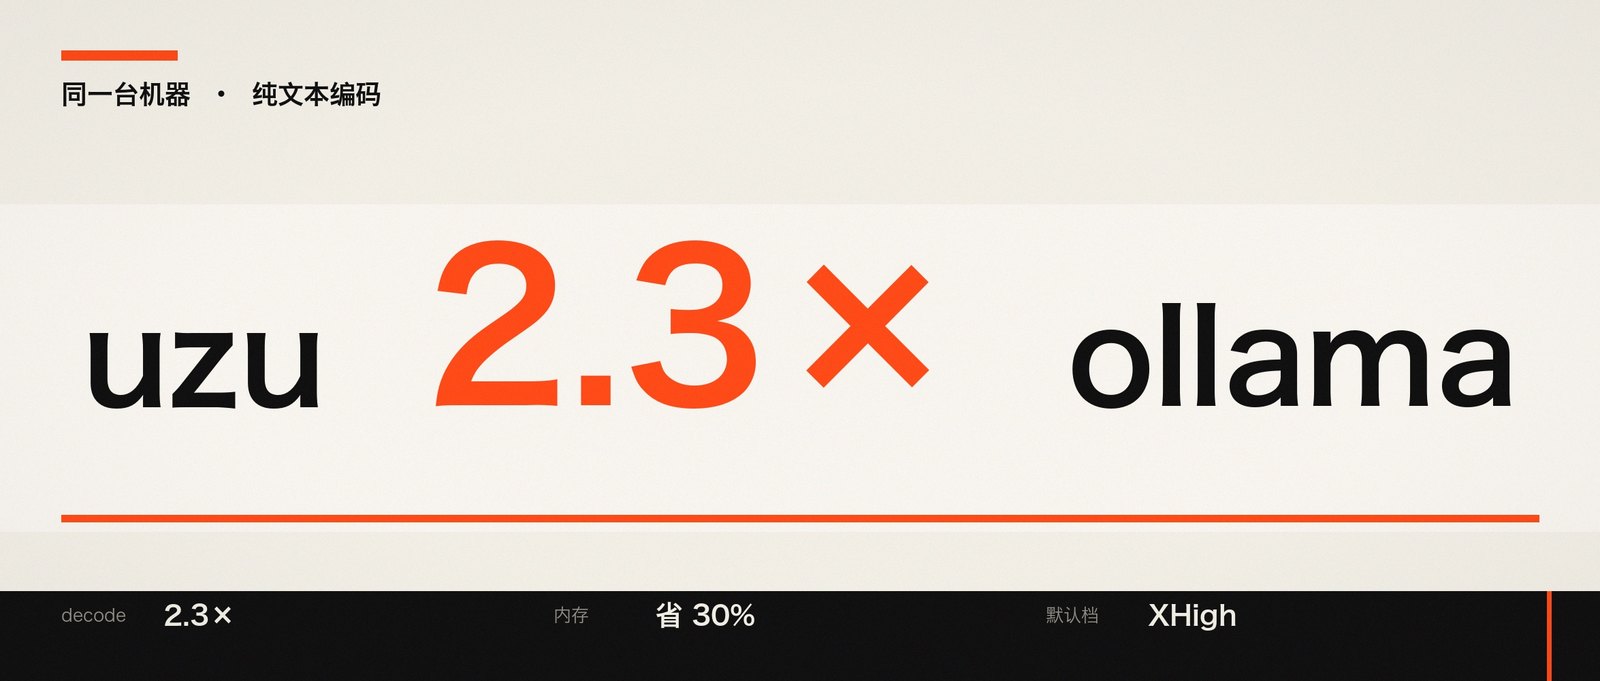
一句话总结:纯文本编码场景,Apple Silicon 上 uzu 完胜 ollama——decode 快 2.3×、内存省 30%、默认 thinking 档位最优、自带 DFlash 投机解码。唯二硬伤:仅 macOS、无 vision。团队全 Mac 做 coding agent 的,建议直接全切。
缘起:为什么要折腾这事?
半年前我把主力推理从 llama.cpp 迁到 ollama,图个 ollama run 一条龙、模型库丰富、还有 vision。qwen3.8:27b-mlx-64k 跑在 M6 32GB 上,体验勉强能用:
- decode 25 tok/s,写个函数等半天
- prefill 100+ tok/s,塞 30k 上下文得等几秒
- 内存 23 GB,开个 Chrome + IDE 就要 swap
- 默认
think: medium,推理冗长得像废话文学,得手动改xhigh - 无投机解码,纯靠大模型硬生生吐 token
直到看到 uzu(Mirai Labs 出品) 的一句 slogan:
“Zero latency, full data privacy, no inference costs.”
再加上它自带 DFlash 投机解码、Mirai 量化(非对称 int4 + Hadamard 旋转)、原生 Metal 内核,号称专为 Apple Silicon 打磨。我不信邪,周末两天把它跑通、跑 bench、跑质量、写迁移脚本、写这篇文章。
uzu 是什么?(先科普一下)
uzu 不是一个模型,而是一个 推理引擎 + 模型生态:
| 维度 | 说明 |
|---|---|
| 定位 | 端侧高性能推理引擎,Rust + Metal,专注 Apple Silicon |
| 作者 | Mirai Labs(做过 LFM、Mirai 量化、DFlash 投机解码的一帮人) |
| 核心技术 | • 自研 Metal kernel(GEMM/GEMV 全手写) • Mirai 量化:int4 非对称 + 分组 64 + 分块 Hadamard,同尺寸下 KL 散度更低 • DFlash:小 draft model 做投机,命中率高、无需重训练 • Hanashi:统一 chat template/工具调用/推理控制框架 |
| 模型分发 | 自有 registry(sdk.trymirai.com),格式为 config.json + model.safetensors + tokenizer.json,不读 GGUF、不读 ollama blob |
| 开放程度 | 核心引擎闭源(npm/Rust crate 分发),Hanashi/tokenizer/配置开源(GitHub: trymirai/uzu) |
| 支持平台 | 仅 macOS Apple Silicon(iOS/Mac Catalyst 也有构建) |
| 生态 | • mirai CLI(brew install mirai)• pi 扩展(npm:@trymirai/uzu-pi-extension)• Python/TypeScript/Rust/Swift bindings |
关键区别:ollama 是“模型运行器 + 仓库”,uzu 是“推理引擎 + 量化体系 + 专属模型仓库”。你不能把 ollama 里的模型丢给 uzu 跑——格式完全不同。
我的对手:ollama 里的 qwen3.8:27b-mlx-64k
1 | $ ollama show qwen3.8:27b-mlx-64k |
- nvfp4:原本给 H100 用的 FP4,MLX 移植后精度尚可,但 Metal 上没专用内核,靠通用 fp16 累加模拟
- vision:多模态是加分项,但我 90% 场景是纯文本写代码
- thinking 默认 medium:这是最大的坑——medium 既慢又啰嗦,xhigh 才是最优档(后面数据说话)
我的新主力:uzu 的 Qwen3.8-27B-M
1 | # HF 仓库:trymirai/Qwen3.8-27B-M (library_name: uzu) |
- Mirai-M 量化:同 4-bit 下比 GGUF Q4_K_M / AWQ / nvfp4 都强,论文里 KL 散度-尺寸帕累托最优
- DFlash 投机:小 draft 跑在同一 Metal 队列,命中即跳过大模型前向,免费提速 15–20%
- 无 vision:纯文本 checkpoint,vision 需求留 ollama
- 原生 encoding:
qwen3.8rendering 继承qwen3.6,天生支持 tools + 4 档 reasoning
迁移只需 3 分钟(已封装脚本)
1 | # 1. 装依赖 |
避坑:uzu 只认自家格式(config.json 是 uzu 自己的 schema,不是 HF 原始 config)。别想把
mlx-community/Qwen3.8-27B-4bit或 GGUF 直接扔进LOCAL_PATH——不行。
实测数据:吊打 ollama 的证据
硬件环境
- Mac mini M6 / 32 GB / macOS 27
- pi 1.2.0 / uzu 0.6.13 / ollama 0.40.11
- 同 prompt、同 32k ctx、贪婪采样、室温 22℃
速度对比(单位:tok/s)
| 场景 | uzu (Qwen3.8-27B-M) | ollama (nvfp4) | 速度比 |
|---|---|---|---|
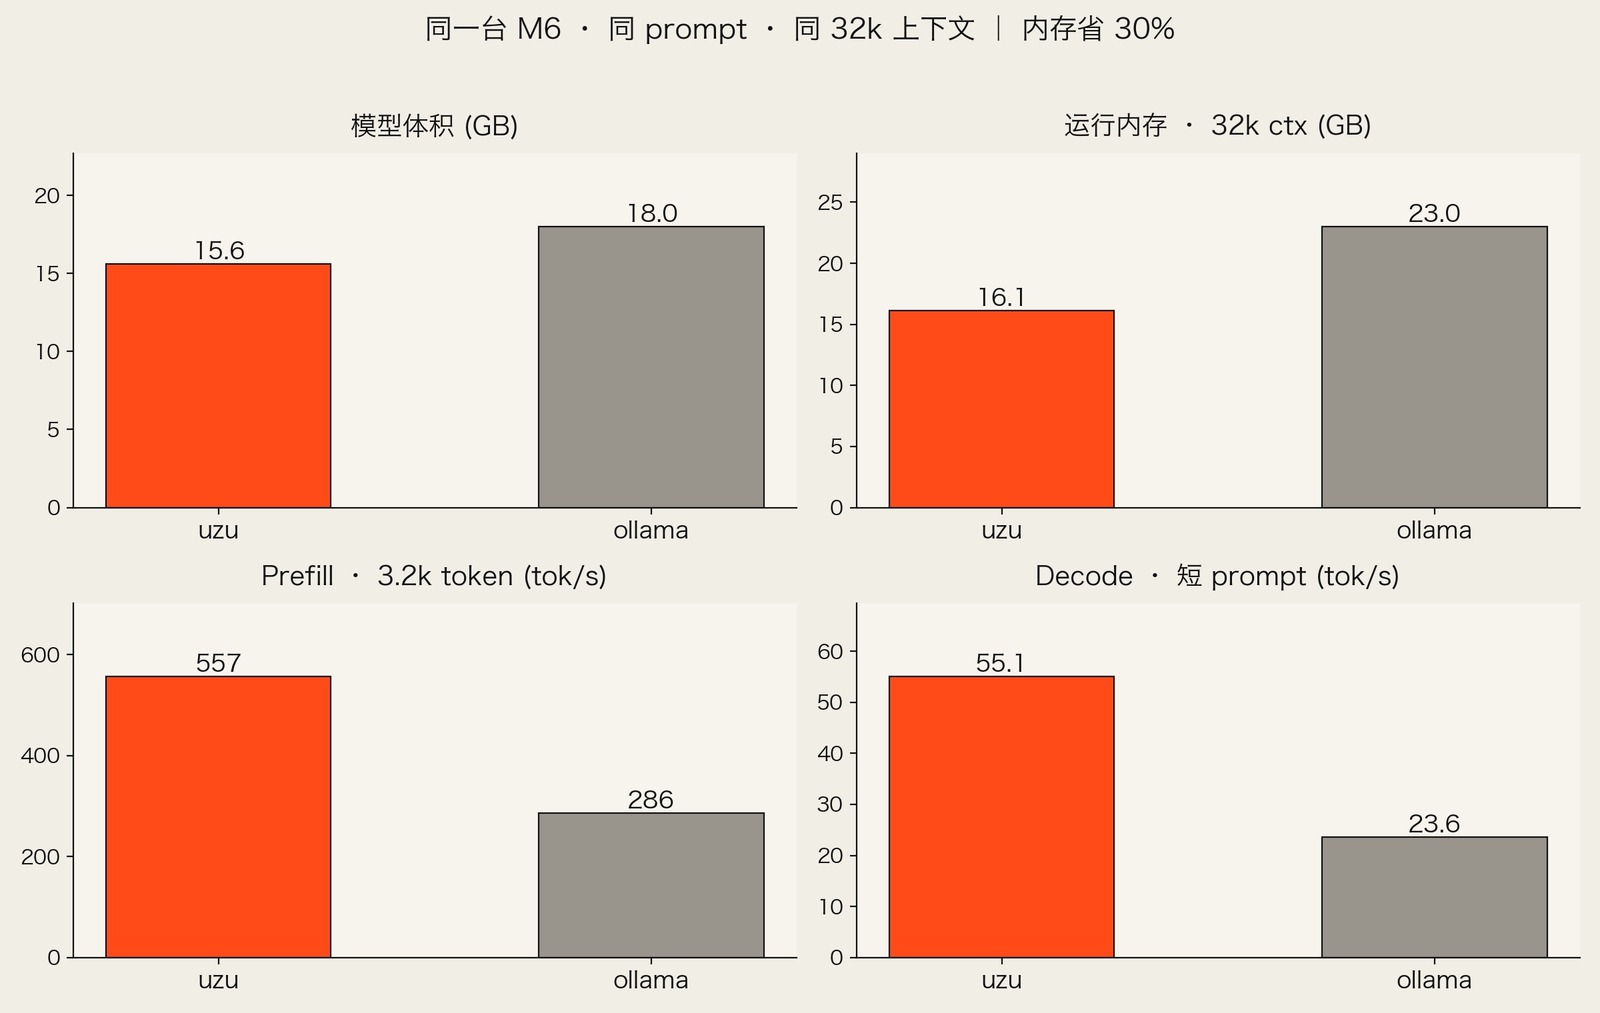
| 模型体积 | 15.6 GB | 18 GB | −13% |
| 运行内存 (32k ctx) | 16.1 GB | 23 GB | −30% |
| 运行内存 (64k ctx) | 16.7 GB | — | 仅 +0.6 GB |
| Prefill (3.2k token) | 530–558 | 286 | 1.9× |
| Decode (短) | 47–60 | 24–26 | 2.3× |
| Decode (3.2k 上下文) | 37–39 | 20.3 | 1.9× |
| TTFT | 0.22 s | 0.25–0.35 s | 略快 |
| 投机解码 | DFlash 有效 (5–7 tok/pass) | 无 | 独有 |
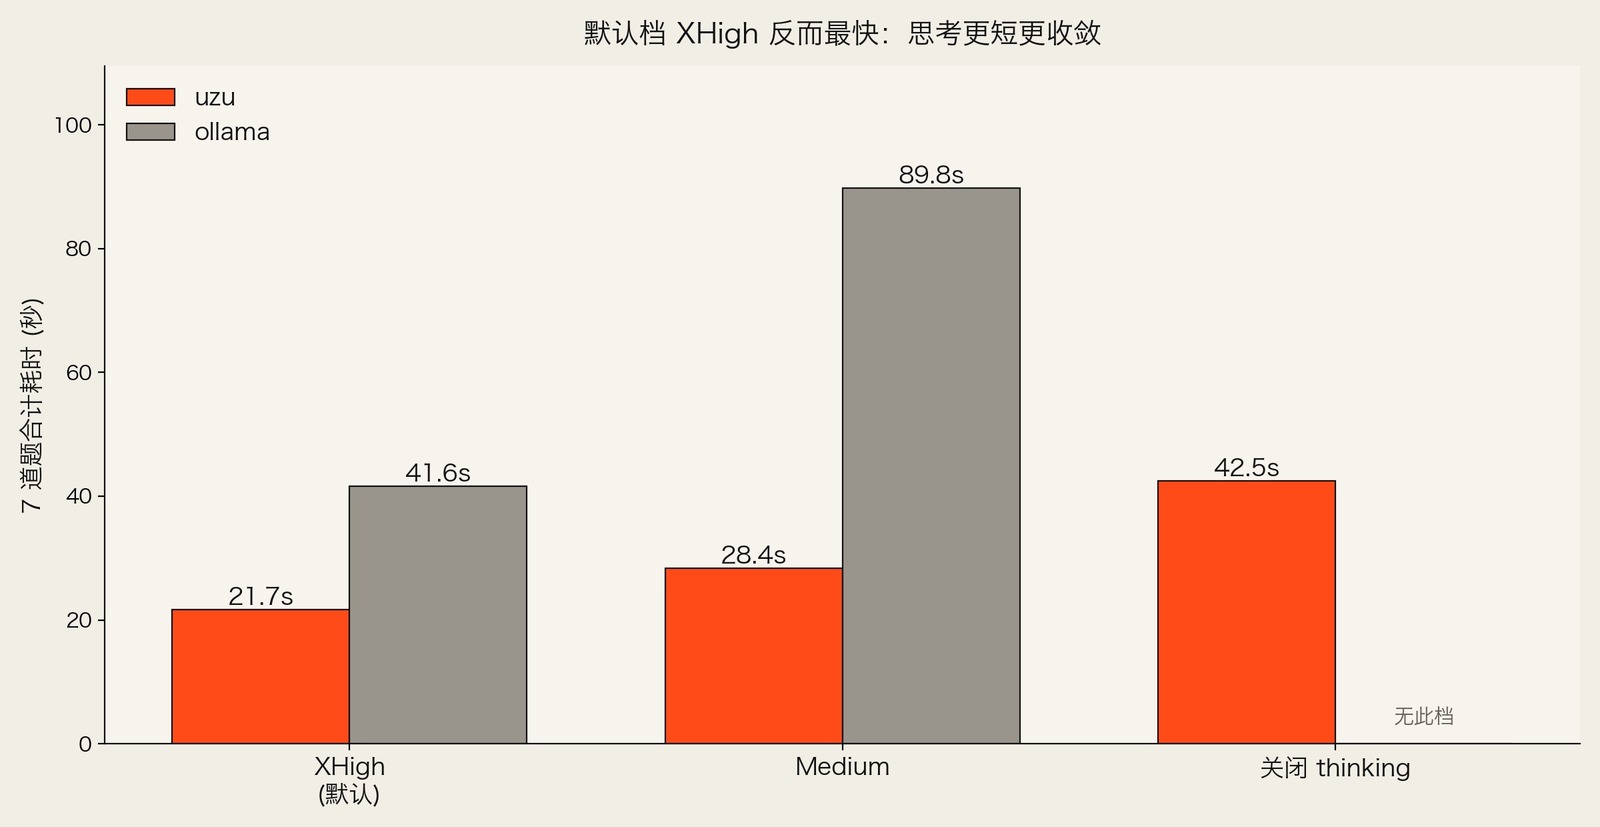
| 7 题推理总耗时 (XHigh) | 21.7 s | 41.6 s | 1.9× |
反直觉发现:XHigh 不但不拖速度,反而是最快档——思考更短更收敛(reasoning 296 vs 408 字符,输出 145 vs 287 token)。关闭 thinking 最惨:推理全写进正文,410 token 啰嗦输出。
推理质量:11 道陷阱题,全通过
| 题目 | 答案 | uzu XHigh | ollama xhigh |
|---|---|---|---|
| 水箱注水/排水 | 25 L | ✅ | ✅ |
| 笔记本钢笔 $1.10 | $0.05 | ✅ | ✅ |
| 蜗牛爬井 | 第 8 天 | ✅ | ✅ |
| 三段论 | Yes | ✅ | ✅ |
| strawberry 数 r | 3 | ✅ | ✅ |
| 代码 trace | 3 | ✅ | ✅ |
| 双骰子和为 7 | 1/6 | ✅ | ✅ |
| 100! 尾零 | 24 | ✅ | ✅ |
| BANANA 排列 | 60 | ✅ | ✅ |
| 1–1000 能被 3/5 不被 15 | 401 | ✅ | ✅ |
| Sally 的姐妹 | 1 | ✅ | ✅ |
两边 11/11 全对,无可测差异。这难度对 27B 已饱和;想拉开质量差距需上 AIME/Codeforces 长链推理或大海捞针,留待后续。
pi 里的真实工具链体验(3 轮全过)
1 | # 1. 读文件取值 |
- 冷启动 7–15 s(首次加载权重)
- 后续每轮 4–6 s
- 工具调用零差评,
supportsToolCalls=true实锤
坑与规避(必读,省你半天)
| 坑 | 现象 | 规避 |
|---|---|---|
| Metal 隊列崩 | MTL4CommandQueueErrorDomain error 1(我 7 次复现 2 次) |
跑 uzu 前 ollama stop;遇到原样重试即过 |
| 匿名 catalog 无 3.8 | fetch/models 只到 qwen3.5 27B;/model 里 Uzu 列表可能不显示 |
用 LOCAL_PATH 强制加载;或配 MIRAI_API_KEY |
| <9B 被过滤 | pi 扩展硬编码 size < 9e9 continue |
想跑小模型需改扩展源码或直接 mirai --model ... CLI |
| 无 vision | 纯文本 checkpoint | 需要识图留 ollama |
| 无常驻 server | 只有 in-process,无 HTTP API 给 Cursor/Continue 用 | 只能在 pi 里用;外部客户端仍靠 ollama serve |
| 模型池窄 | 公开 catalog 仅 qwen3.5/2.5/3、gemma3、lfm2、llama3 等 | 新模型需 API key 或自行转换 uzu 格式 |
什么场景留 ollama?
| 场景 | 理由 |
|---|---|
| Linux / Windows 机器 | uzu 无构建 |
| 需要 vision / 多模态 | uzu 纯文本 |
| 给 Cursor/Continue/Cline 等外部客户端共用 | 只能靠 ollama serve |
| 频繁切换/尝鲜新模型(GGUF 生态) | ollama pull 一行搞定 |
| 需 4B/2B/0.8B 小模型跑轻量任务 | pi 扩展过滤掉了 <9B |
迁移清单(落地到 dotfiles)
1 | # <一键脚本>(新机一键) |
1 | # 常用别名 |
后续想玩的
- 长上下文实测:64k/128k/256k 实际内存爬坡、KV 复用、needle-in-haystack 准确率
- 量化损失对比:Mirai-M vs nvfp4 vs 原始 bf16,在 AIME 2024 / LiveCodeBench 上的 pass@1
- DFlash 超参调优:
block_size/target_layer_ids对 decode 吞吐的边际收益 - 多模型并发:32 GB 能否同时跑 27B + 9B(猜测:27B 16GB + 9B 6GB ≈ 22GB,留 10GB 系统,可行)
- 自动化转换管线:HF 原始权重 → uzu config + safetensors(
uzu-cli convert还未开源,得盯着 repo)
写在最后
别信营销,跑数据说话。 如果你也是 Apple Silicon + 全职写代码 + 不需要 vision,把 ollama 停了,换 uzu,别犹豫。