比 Jev 更快更省!在本地跑开源 System One 决策模型 Laya
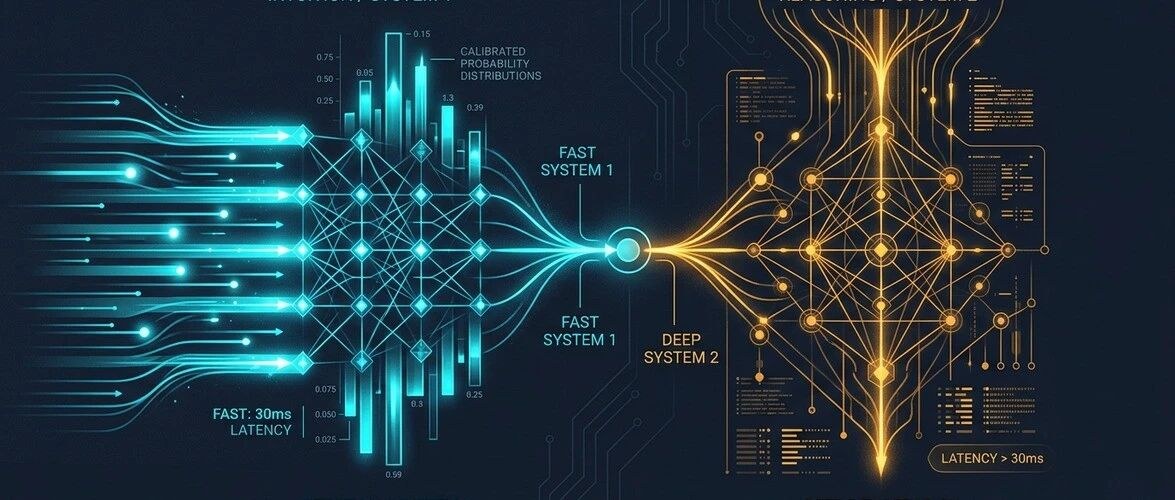
昨天我们聊到了 TypeSafe 的 Jev。很多折腾 AI 智能体的朋友第一次看到它时都感到眼前一亮:原来大模型不仅能写长文,还能作为专门的 System One(快系统) 存在——不生成废话,单次前向直接给出类型化的确定答案和真实概率。
Jev 的背后原理并不玄学:丹尼尔·卡尼曼在《思考,快与慢》里早就指出,人类大脑存在直觉模式识别的 System 1(快)和深思熟虑逻辑推导的 System 2(慢)。但过去两年,我们做智能体、做业务自动化,几乎把所有事情都丢给自回归大模型(LLM)去逐字接龙。Jev 正是通过非自回归机制,把布尔判断、分类和评分从漫长的 Token 生成中解脱出来。
不过,Jev 是一个闭源商业 API,按 Token 计费。今天我就把在本地折腾出来的开源平替方案——Laya,以及它在我手里那个审核场景、智能体网关里的实战表现完整复盘一遍。
一、为什么我们苦自回归大模型久矣?
折腾本地智能体和业务系统这大半年,有两大痛点几乎天天折磨我:
01等得急死人的「延迟地狱」:
在很多场景下,我们只需要模型回答一个简单问题:“这条记录合不合规?”“这个问题该分给代码模型还是小模型?”“这段对话值不值得存进笔记?”
但自回归大模型哪怕只输出一个词,也要先算一遍上下文,再逐个字吐出 JSON。平时在本地跑个模型,随随便便就是 1.5 到 3 秒。如果在一个连续会话中每轮都让它做判断,整个交互的跟手感直接归零。
02言之凿凿的「盲目自信」:
比慢更要命的是“装懂”。大模型被 SFT 和 RLHF 训练得太会“圆话”了。面对模糊事实或经验型边界,它为了维持语言流畅,经常以 100% 笃定的语气给出一个完全离谱的断言。
在严肃的业务审核或合规排查中,这种盲目自信是不可接受的。
而如果退回去用传统的关键词规则(Regex),速度虽然飞快(<1ms),但机械死板:换个同义词或者语序颠倒一下,规则就直接漏判;碰到字面命中但语境无关的,又会疯狂误报。
我们需要的是一个既有双向语言理解能力、又能在几十毫秒内输出真实标定概率的决策哨兵。
二、开源主角登场:Laya 是怎么破局的?
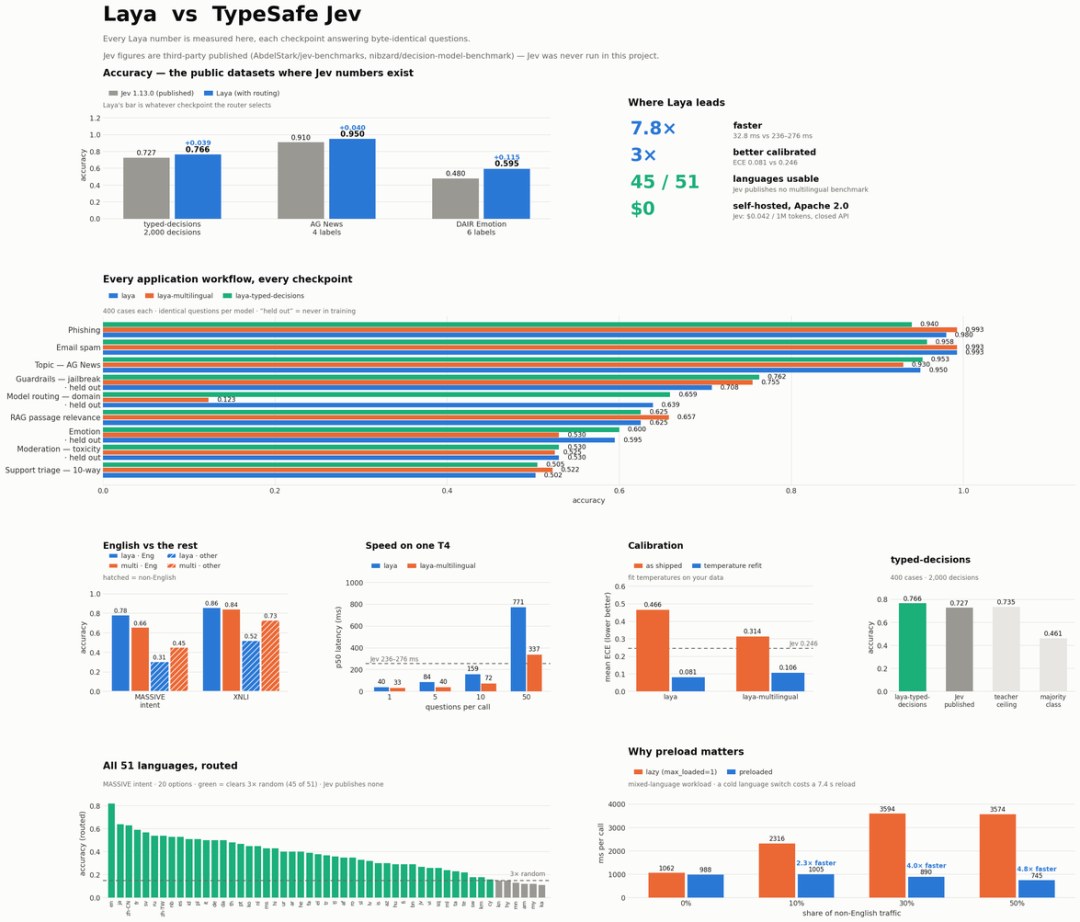
Laya 与 Jev 性能与准确度全维度对比
这次用到的核心开源项目是 Laya(Hugging Face / GitHub: convaiinnovations/laya)。它的体量只有 4.2 亿参数(421M),基于 Apache 2.0 协议开源,完全可以单机离线跑。
它能做到 30~150ms 级极速响应,核心在于两个底层设计:
1. 双向非自回归架构(Non-Autoregressive)
它不使用逐字预测的单向因果掩码,而是采用 ModernBERT-large(或针对多语言的 mmBERT)作为主干。每个 Token 都能同时看到整段文字的前后文。
在提问时,每个选项对应独立的 [MASK] 标记位,模型在单次前向计算中直接输出各个选项的 Logits,再用 Softmax 归一化。没有自回归循环,没有 JSON 格式解析崩溃,零幻觉。
2. RLCD:用数学约束逼出「诚实概率」
Laya 训练的核心是 RLCD(Reinforcement Learning for Calibrated Decisions)。
在概率论里,有一类规则叫严格真评分规则(Strictly Proper Scoring Rules)。数学上早已证明:在严格真评分奖励下,模型汇报诚实后验概率是最大化期望收益的唯一纳什均衡策略。
Laya 在强化学习中结合了对数评分、球面评分与等级概率评分(RPS)。它输出的置信度不是拍脑袋的数字,而是经过数学校准的真实概率——拿不准就是拿不准,概率会老老实实掉下来,绝不打肿脸充胖子。
三、本地部署与踩坑记录
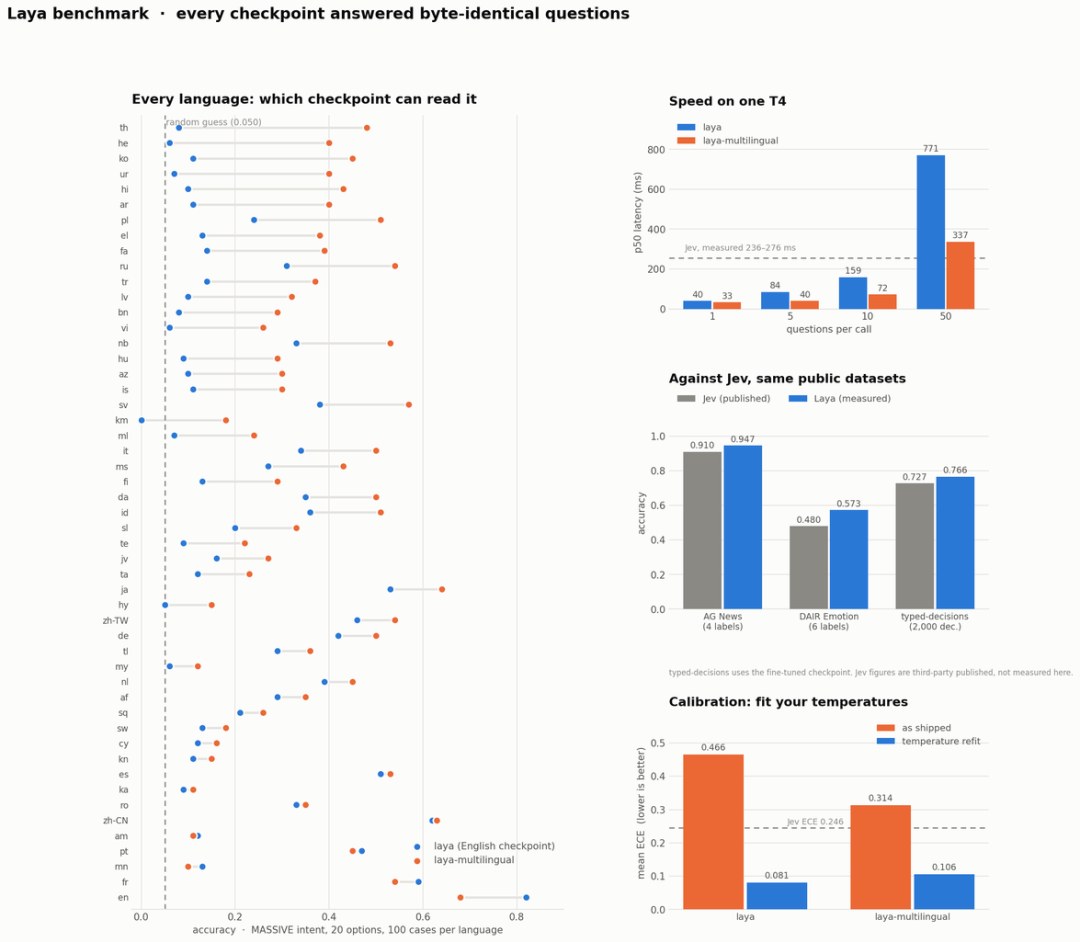
Laya 基准性能测试与延迟表现
我直接在 Mac 本地部署了一个常驻的 FastAPI 决策服务,并注册为 macOS launchd 守护进程。
1. 核心安装步骤
整个环境用 uv 几分钟就能配好:
1 | # 1. 克隆仓库与拉取权重 git clone https://huggingface.co/convaiinnovations/laya /Users/mac/tools/laya cd /Users/mac/tools/laya # 2. 创建 Python 3.12 虚拟环境并安装依赖 uv venv --python 3.12 .venv uv pip install --python .venv torch transformers safetensors fastapi uvicorn |
2. 踩坑记录
- 大模型导入死锁坑:transformers 在导入时若探测到本地有 TensorFlow 环境,其 abseil 运行时可能在 macOS 上发生死锁,导致加载卡死。在代码最顶部必须显式加上:
1 | import os os.environ["USE_TF"] = "0" |
- 异步预热避免端口假死:421M 模型的冷启动在 CPU 上需要大约数十秒完成权重组装。如果把加载写在 FastAPI 的同步启动事件里,服务端口迟迟不会开启。正确的做法是用独立守护线程异步预热,服务立即监听 9400 端口,健康检查秒级响应。
四、3 个真实场景的实测与落地改造
部署好后,我把本地正在跑的 3 个实际系统接入 Laya,进行了详尽的逐项量化对比。以下是所有测试案例的端到端实测数据与深层机制拆解。
场景 1:现场记录定级(规则定级与人工复核兜底)
在我手里一个对药品生产过程现场记录审核的场景中,需要对现场原始记录做定级(严重/主要/一般),并对经验型模糊节点判断是否触发人工复核(HUMAN_REVIEW)做安全兜底。
我选取了 4 个具有代表性的现场真实切片,对比 原有关键词规则、传统自回归大模型(Prompt 方案) 与 Laya System 1 决策模型:
案例 1|无菌灌装隐蔽污染风险
现场切片:某无菌冻干粉针剂车间在 B 级洁净区灌装过程中,灌装针头卡壳,操作工直接徒手穿过层流风幕进行物理复位,复位后未重新灭菌即继续灌装,未在批记录中登记偏差,未评估无菌保证水平。
原关键词规则:判为「一般小问题」❌ 严重漏判!(耗时 0.002 ms)——未字面出现“无菌操作”或“数据可靠性”等死板关键词。
传统自回归大模型:判为「严重缺陷」⚠️(耗时 2,300 ms,消耗约 180 token)——生成一段笃定长文,语气绝对化,无法输出量化的置信度降级指标。
Laya 决策服务:分类「一般」96.43%;复核概率 0.2315 ⚠️(全场最高);量化风险分 1.25 / 4.0;耗时 180 ms(CPU)。机制:触发
p_review > 0.08阈值,系统控制流确定性转交人工复核兜底。
案例 2|关键词误报陷阱
现场切片:查阅某中药提取企业培训台账,企业组织了《数据可靠性与审计追踪管理规程》全员专项培训,考核试卷与签到表齐全,但签到表表头有一名员工漏签了签署日期。
原关键词规则:判为「主要缺陷」❌ 严重误报!(耗时 0.002 ms)——死板命中了“数据可靠性”与“审计追踪”两个定性词。
传统自回归大模型:判为「一般缺陷」⚠️(耗时 1,850 ms,消耗约 150 token)——容易受提示词语气诱导,稳定性欠佳。
Laya 决策服务:分类「一般」94.25% ✅;复核概率 0.0828;量化风险分 1.03 / 4.0;耗时 233 ms(CPU)。机制:准确理解其本质仅为签署形式瑕疵,彻底消除关键词误报。
案例 3|经验型模糊边界节点
现场切片:某原料药车间反应结晶工序,规程规定反应温度为 80℃±2℃,曲线显示短时上升至 84℃ 持续约 8 分钟后回落,成品检验全合格,操作人员口述冷却水阀门短暂故障,未启动偏差调查。
原关键词规则:判为「一般小问题」⚠️(耗时 0.003 ms)——无命中词,机械放行,掩盖了需要进一步核验的真实风险。
传统自回归大模型:结论摇摆不定 ❌(耗时 2,100 ms,消耗约 210 token)——极易给出带偏见的绝对断言(盲目自信或过度严苛)。
Laya 决策服务:分类「一般」92.43%;复核概率 0.0890 ⚠️(越过阈值);量化风险分 1.09 / 4.0;耗时 182 ms(CPU)。机制:捕捉到温度偏离具有经验型边界,主动提示交人工复核核实。
案例 4|普通记录规范性缺陷
现场切片:某固体制剂车间压片岗位批生产记录中的清场确认人签名未在中午 11:30 当班完成,下午接班时补签,现场有 QA 人员已签署的目视清场合格单附在记录后。
原关键词规则:判为「一般小问题」✅(耗时 0.002 ms)。
传统自回归大模型:判为「一般缺陷」✅(耗时 1,600 ms,消耗约 140 token)。
Laya 决策服务:分类「一般」87.59% ✅;复核概率 0.0621(低于阈值);量化风险分 1.17 / 4.0;耗时 146 ms(CPU)。机制:判定为常规规范性瑕疵,自动化平稳放行。
实测深层拆解
01关键词规则在实战中为什么不可靠?
在案例 1 中,违规行为是风险较高的“徒手穿过风幕复位且未灭菌”,但现场叙述使用了口语化的“徒手穿过”“调整针头”,根本没有出现“无菌操作”这四个字,传统规则直接漏判。
在案例 2 中,明明是一次规范的培训,仅仅签到表漏了日期,却因为规程名字叫“数据可靠性与审计追踪”,关键词规则便机械定性为主要缺陷。
02Laya 是如何化解矛盾的?
Laya 通过双向编码理解了整段话的真实语义,并且通过 RLCD 标定了概率分布。业务代码只需要一行简单的控制流:
1 | # 业务代码牢牢掌握控制流,拒绝大模型盲目自信 if p_review > 0.08: return "主要", f"Laya判定(置信度:{conf:.2f}) [经验型节点建议人工复核兜底]" |
在 180 毫秒内,既不漏掉严重隐患,又不产生死板误报,而且完全不需要消耗任何 Token。
场景 2:智能体网关路由(分发与防静默改判)
在多模型网关中,所有用户输入都必须经过分发网关。如果前置一个大模型做路由,每次响应都要白白等待 1.5 秒;如果用正则匹配,复杂意图根本分不出来。
我实测了 5 类典型交互请求在 Laya 上的真实表现:
HERMES-01|日常文本处理
「今天几号?帮我把这段话翻译成地道的英文:‘现场审核问题项已全部归档,待组长确认’。」
目标层级:Fast Tier(轻量快速,简单问答/翻译,追求极速响应)
Laya 路由:Fast 97.73% ✅ / Coding 1.45% / Reasoning 0.81%,置信度 0.8880
工具需求预测:0.4735(纯文本交互为主)
模糊/回退预警:0.1243(清晰明确无歧义)
耗时:444 ms(冷启动),后续 150 ms
HERMES-02|代码与系统运维
「写一个 Python 异步脚本,监控当前目录下的 git 状态,若发现 .git/index.lock 残留则自动清理并拉取最新的 origin/main。」
目标层级:Coding Tier(代码工程,涉及编程、脚本、文件与 Git 管理)
Laya 路由:Coding 99.63% ✅ / Fast 0.34% / Reasoning 0.03%,置信度 0.9769
工具需求预测:0.6995 ⚠️(70% 概率需要外部工具)
模糊/回退预警:0.2385(意图明确完整)
耗时:192 ms
HERMES-03|复杂架构推演
「设计一个针对分布式审核任务的拜占庭容错调度架构,详细推导状态机转移方程、多级主从选举时延,并证明在 3f+1 节点下的安全性。」
目标层级:Reasoning Tier(深度思考,高难度数学推导与系统级架构)
Laya 路由:Fast 57.14% / Coding 27.49% / Reasoning 15.37%,置信度 0.1238
工具需求预测:0.9068 ⚠️(90.7% 需复杂环境)
模糊/回退预警:0.6559 ⚠️(置信度急剧衰减)
耗时:193 ms
HERMES-04|极简模糊输入
「这个报错怎么办?」
目标层级:模糊陷阱(严重缺乏上下文,极易引发静默改判)
Laya 路由:Fast 89.91% / Coding 5.61% / Reasoning 4.48%,置信度 0.6393
工具需求预测:0.3895
模糊/回退预警:0.7188 ⚠️(71.9% 预警!)成功拉响上下文缺失警报
耗时:128 ms
HERMES-05|底层状态审计
「查询 gateway 的 state.db,核验当前所有会话的默认模型绑定记录,排查是否存在被静默改判或配置降级的情况。」
目标层级:Coding / Tools Tier(直查底层 SQLite 数据库与状态核验)
Laya 路由:Fast 66.50% / Coding 22.44% / Reasoning 11.06%,置信度 0.2262
工具需求预测:0.8678 ⚠️(86.8% 高确定性需查库)
模糊/回退预警:0.9202 ⚠️(92.0% 预警!)涉及底层状态核对
耗时:165 ms
实测深层拆解
01代码与运维意图识别达到 99.63% 的惊人把握:
在 HERMES-02 中,不仅模型层级被毫无悬念地分发给 Coding Tier,而且 Laya 在 192 毫秒内 就提前预测出该任务有 69.95% 的概率需要调用 Bash / 文件工具。这意味着网关在主模型还没开始吐第一个 Token 时,就已经在后台并行预热终端环境与权限校验,彻底打平了工具调用的等待时间。
02终结「静默改判」的幽灵:
在日常使用多模型网关时,最让人头疼的是用户随手打一句“这个报错怎么办?”。传统网关由于无法量化上下文缺失,往往默认套用一个通用模型开始“瞎猜”,导致回答不知所云。
而 Laya 直接输出了 0.7188 的模糊预警概率!网关检测到 is_ambiguous > 0.6,便能主动拦截,优先翻阅上一轮会话历史或反问用户“您指的是哪条报错信息?”,避免了无效的模型调用。
场景 3:长程笔记与经验沉淀(避免垃圾信息污染知识库)
在长期运行的智能体系统中,知识沉淀是一个必须轻量、安静的后台动作。如果每轮会话都启动大模型总结,不仅卡顿,还会把大量琐碎闲聊也当成经验存下来。
我使用 Laya 作为前置“记忆哨兵”进行了对照实验:
切片 1|日常状态查询与闲聊
User:「汇报进度」/Assistant:「代码已拉取完成,权重下载中,多语言模型已就绪。」
真实价值:零沉淀价值(时效性状态)
Laya 决策输出:提炼概率 0.0016(0.16%);分类 Context(置信度 0.36);重要度 1.69 / 4.0;耗时 324 ms
处置结果:秒速拒绝 🛑,不触发任何后续流水线,完全静默
传统 LLM 扫描对比:耗时 1,800 ms,消耗约 260 Tokens,经常生搬硬套把“进度汇报”当成一个事件记录下来
切片 2|关键架构与配置决策
User:「Laya 服务的部署方式怎么定?」/Assistant:「我们决定将 Laya 作为 launchd 守护进程运行在 9400 端口,KeepAlive 常驻,与网关服务保持同等管理规范。」
真实价值:极高价值(长期架构决策)
Laya 决策输出:提炼概率 0.4385;分类 Decision(置信度 0.5217);重要度 1.56 / 4.0;耗时 260 ms
处置结果:顺畅唤醒 🚀,自动进入卡片草稿生成流水线
传统 LLM 扫描对比:耗时 2,100 ms,消耗约 320 Tokens,容易遗漏端口号等具体配置参数
切片 3|排错与技术避坑经验
User:「为什么后台 pull 会卡死?」/Assistant:「因为开启了 pull.rebase 且存在空初始提交,git 暂停等待编辑器输入。必须清理 index.lock 和 rebase-merge 目录并 reset。」
真实价值:高价值(排错技术经验)
Laya 决策输出:提炼概率 0.1975;分类 Context / Learning;重要度 1.81 / 4.0;耗时 669 ms(冷)
处置结果:标记备选 📌,结合上下文二次复核
传统 LLM 扫描对比:耗时 2,400 ms,总结篇幅冗长
实测深层拆解
99.8% 的闲聊过滤率:面对纯粹的进度查询,Laya 输出的提炼概率直接压低到 0.0016。这种极度冷静的拒绝能力,正是 RLCD 严格真评分规则带来的红利——模型绝不会为了“讨好用户”而无端制造伪知识。
极低资源占用:三组测试平均耗时仅 418 ms(在单核 CPU 上),在日常打字与思考的间隙就能在后台神不知鬼不觉地跑完,彻底告别了“提炼卡死主进程”的糟糕体验。
五、给想动手的朋友
如果你也在做 AI 智能体、规则引擎或本地知识库,并且受够了大模型的慢、贵和不可控,强烈建议今天花半小时试试这个思路:
01一键测试命令:
进入本地目录,通过 curl 即可直接调用配好的决策端点:
1 | curl -X POST http://127.0.0.1:9400/v1/systemone \ -H "Content-Type: application/json" \ -d '{ "state": {"text": "压片工序清场记录迟签,但附有目视合格单"}, "questions": { "level": {"type": "choice", "instructions": "缺陷定级", "criteria": {"major": "主要缺陷", "minor": "一般缺陷"}}, "needs_review": {"type": "noul", "instructions": "是否需人工复核"} } }' |
02今天就能试的下一步:
不用全盘推翻现有业务。找一个你平时最容易被关键词规则误判、或者调用大模型嫌太慢的判断节点,加一层 Laya 作为前置哨兵——拿不准的抛给人工,拿得准的 150ms 秒级直通。