用实例对比测试 Apple 自带的 OCR 和 PaddleOCR 哪个强
苹果电脑里自带一个 OCR。它是系统里的 Vision 框架,不用装、不用连网、不花钱,截图取字、扫描件转文本都靠它。中文走系统里的模型,识别过程不出本机。
PaddleOCR 是另一条路,出自百度飞桨的开源项目。它得自己部署:建 Python 环境、下模型,装完占将近一个 G。换来的是参数可调、模型自己挑,一样在本机跑。
两个都能离线干活。同一份两百多页的 PDF、同一批渲染图,各跑一遍,比速度、比漏字、比标点,顺手还试了手写。
怎么比的
两个引擎处理的是同一份扫描版 PDF、250dpi、共 267 页。苹果那套走系统接口,脚本批量调;PaddleOCR 装在独立环境里,用默认的中文模型。
要比四样:快不快、准不准、标点和括号规不规范、手写体认不认。最后一条是额外加的,手上正好有手写笔记的扫描件。
速度:差了近百倍
前 21 页,苹果那套 4.0 秒跑完,PaddleOCR 花了 398 秒。98 倍。单看一页更直观:平均一页 19 秒。
又拿 167 整本对跑了一遍:苹果那套按实测速度折算约 36 秒,PaddleOCR 实测 3363 秒,也就是 56 分钟,差 93 倍。这一趟它一次跑完,中途没出问题。两百多页照这个速度外推,得跑一个半小时。
顺便记个坑。苹果那套有个 fast 档,同一批 21 页 0.9 秒就跑完了。但输出只有 2943 字、139 行,正文大片是空的。中文正文别用它,老实选 accurate 档。
同一个任务,一台机器一下就干完,另一台要摇很久
准不准:找了把客观的尺子
比”哪个准”最容易变成各说各话。这份 PDF 帮了个忙:正文虽然转成了,但每个字在文件里还是一个独立的图形块。数了一下,21 页一共 6760 个。
尺子就是它。拿引擎输出的行框去盖这些图形块,盖住几个块,这行就该有几个字,再跟它实际认出的字数比。差为负就是漏字。这把尺子跟哪个引擎都没关系,两边各自独立量。
量下来:苹果那套 21 页漏字 4 行,占 352 行的 1.14%。PaddleOCR 漏字 0 行。
范围拉到整本 167 页,苹果那套漏 92 行,占 5699 行的 1.61%。这个数和 167 页子集量出的 1.66% 基本一致,说明尺子换个样本也稳。更要留意的是那 92 行里,有 38 行它报的置信度是满分 1.0——它不知道自己漏了字。
PaddleOCR 那边把 167 页也补量了:漏 5 行,占 3575 行的 0.14%。这 167 页两家都量过,可以直接比:苹果那套 60 行(1.66%),PaddleOCR 5 行(0.14%),差 12 倍。
这 5 行逐行看过,成色不一样。1 行是把全角尖括号「<」整个吃掉了;剩下 4 行集中在同一页——那是张一两千字的密集小字表格,两栏挤在一起。它把”有助于改善”读成了一个”员”字,把”体内脂肪”读成了”房刷”。这两处裁出原图核对过,确实是读错,不是尺子的问题。也就是说它漏字少,但真漏起来是整行读歪,不像苹果那套那样只少一个”的”。
漏字比多字麻烦。多出来的一般是行被拆开、或者数字和英文之间多个空格,肉眼看得见;漏字是悄无声息少一个,不逐字核根本读不过去。
抓到的实例。一句真值读作”建立相应的自检制度”,苹果那套给的是”建立相应自检制度”,中间那个”的”没了。还有一句”担忧和恐惧的内容”,它认成了”担忧和恐惧钓内容”,”的”变成了”钓”。这两处把那一行单独裁出来重喂了一次,确认不是版面切分的问题,是识别本身丢了字。
这两个地方,PaddleOCR 都是对的。
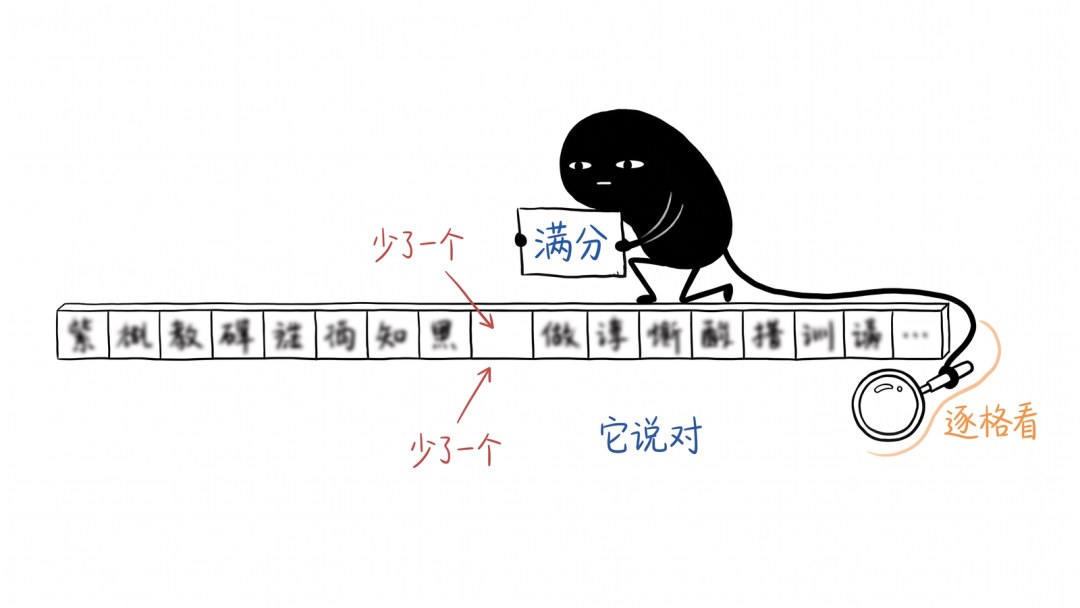
少掉的那一格没人发现,满分的小牌子就立在缺口上方
(那把尺子也有短板:数字和英文在图形里会粘连,”多字”的统计里混着这类噪声,真正能用的是”漏字”这一项。)
标点:PaddleOCR 最确定的短板
同样 21 页,把两个结果里的标点按全角半角数了一遍。
逗号、句号、问号、顿号、引号、书名号,两边完全一样,一个不差。拉开差距的是括号和冒号:苹果那套输出的半角括号 0 个、半角冒号 0 个;PaddleOCR 那边有 23 个半角括号和 1 个半角冒号。
具体什么情况。全角括号一共 124 个(苹果)对 101 个(PaddleOCR),少掉的那 23 个就是掉成半角的,该写”(一)”的地方它给了”(一)”。
排版过的人看到这个会懂:正文里混进半角括号,直接拿去用就得通篇替换一遍。不是大错,但多一道人工返工。
分辨率:往高调确实有用
拿 13 页做了组对照,从 100dpi 一路渲染到 400dpi,各跑一遍苹果那套。
先说字数,六个档位一直是 3994 到 3999 之间,行数永远 224 行,看着像”没差别”。但行级一致率藏不住东西:以 400dpi 为基准,100dpi 95.1%,150dpi 96.4%,200dpi 95.5%,250dpi 94.6%,350dpi 98.2%。250dpi 是倒数第一。
更关键的是漏字。同一把尺子量这 13 页,250dpi 漏 4 行,400dpi 漏 2 行。250dpi 漏掉的那几处,400dpi 补回来三处:
“位建立相应自检制度”(250dpi)→ “位建立相应的自检制度”(400dpi)
“取得直接关系公共利益特定行业”(250dpi)→ “取得直接关系公共利益的特定行业”(400dpi)
“担忧和恐惧钓内容”(250dpi)→ “的担忧和恐惧的内容”(400dpi)
三处都是同一个字:”的”。250dpi 把它丢了或者认错了,400dpi 认对。
但也别推到极端。400dpi 自己也新漏了一处,还是在”的”字上;再加上 250dpi 本来就漏、两档都没修好的一处,最后剩 2 行。真要抠字,最稳的还是两个引擎对着看,光靠堆分辨率只能把误差从一个字挪到另一个字。
手写体:结论完全反过来
上面说的都是印刷体。换到手写,两个引擎的位置直接对调。
同一组手写笔记的扫描页,苹果那套给的是碎片,读不通;PaddleOCR 给的是能顺着读下来的句子,日期也认得全(五页里认出五个日期,苹果那套只认出三个)。那五页它跑了 33.6 秒,一页六秒多。慢,但能用。
所以哪个引擎好,取决于你认的是印刷体还是手写体。这两个场景,赢家不是同一个。
置信度:两边的分数都不能当质检门槛
苹果那套整本5699 行的置信度,只有三个取值——1.0(3640 行)、0.5(1718 行)、0.3(341 行)。它是粗分级的,不是精细打分。麻烦在于,前面那句漏了”的”的话,它报的置信度是 1.0。
PaddleOCR 的分数很细,均值 0.9968、最低 0.93,一行低于 0.9 的都没有。可它也没报出自己那些半角括号。那 5 行漏字里,有 1 行报的是 0.983——几乎满分。分数细,一样不等于能自动拦错。
两边的分数都不能当自动质检的闸门用。要验,只能抽页对照着看。
怎么用:实际分工
印刷体正文用苹果那套,快、标点干净、零安装,跑完抽几页核对。
PaddleOCR 留着干两件事:一是手写,这里没有替代品;二是当第二意见,用它去挑苹果那套漏掉的字。
磁盘上的账也说一下:PaddleOCR 的环境 937MB,这次用到的三个模型(检测、识别、文本行方向)合计 139MB,还得单独备一个 Python 环境。苹果那套就是系统里现成的,加一行 pip 装个桥。
给想动手的人
苹果那套三步:
1 | brew install poppler pdftoppm -png -r 400 你的文件.pdf ./pages/page /usr/bin/python3 识别脚本.py ./pages ./out --workers 6 |
第一行装的是渲染工具,第二行把 PDF 每页渲染成 PNG,第三行逐页识别、每页写一个 txt。分辨率开 400,前面量过,比 250 少漏字。脚本不神秘,一百行以内,看得懂就自己改。注意它得用系统自带的 /usr/bin/python3,别用后来装的 Homebrew Python,那个 import 不进来。
PaddleOCR 那边:
1 | pip install paddleocr python 识别脚本.py ./pages ./out_paddle |
单独建虚拟环境,别和系统 Python 混在一起。
结论
同一条命令渲染出来的一批图,苹果自带那套 4.0 秒跑完,PaddleOCR 398 秒,慢 98 倍,速度上没什么可比性。但苹果那套会静默漏字,漏字的行还可能报满分置信度,所以快不等于能直接交差。
PaddleOCR 反过来:慢、标点会掉成半角、密集小字表格上会整行读歪,可它是唯一能读手写的那个,也是用来抓苹果那套漏字的第二双眼睛。
一句话:印刷体走系统自带,手写走 PaddleOCR,渲染精度往 400dpi 提,两个都留着,抽页对看。