从零手写 Self-Attention:最小 Python 实验指南
·
技术笔记
· 约 8 分钟
从零手写 Self-Attention:最小 Python 实验指南
一、为什么需要自注意力(Self-Attention)?
在传统的序列模型(如 RNN / LSTM)中,信息的传递必须沿着时间步依次串行推进,不仅计算无法并行,而且在长距离上下文依赖时容易发生信息遗忘。
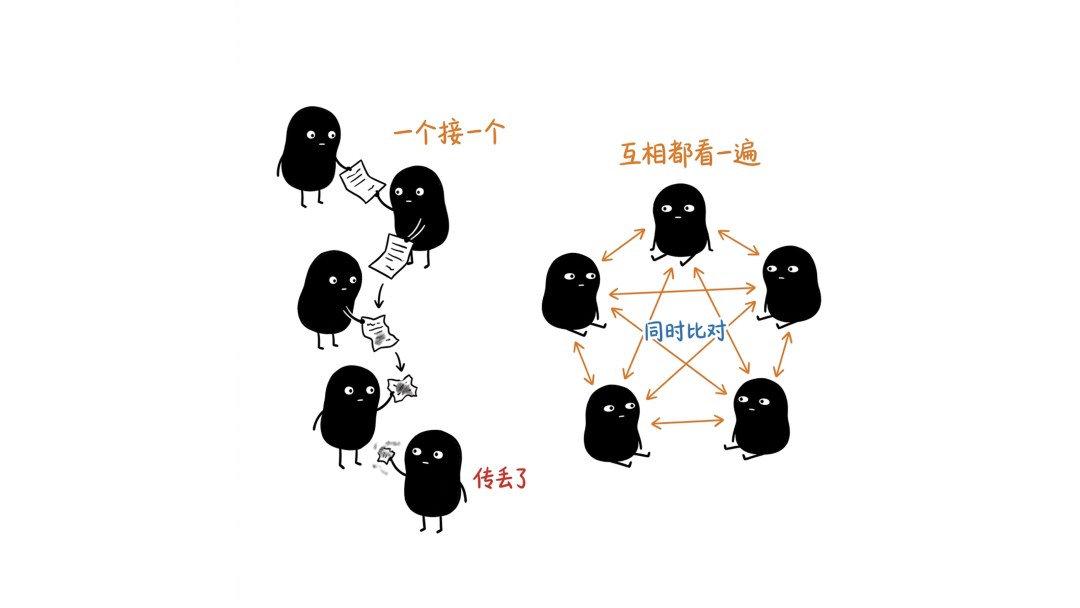
Self-Attention(自注意力机制) 的核心思想非常简单直观:让序列中的每一个 Token(词/特征)直接与当前序列里的所有 Token 进行”打分与比对”,并根据相关度对上下文特征进行加权汇聚。
二、核心三大角色:Q、K、V 的直观比喻
Self-Attention 的精髓在于将输入映射为三种向量:
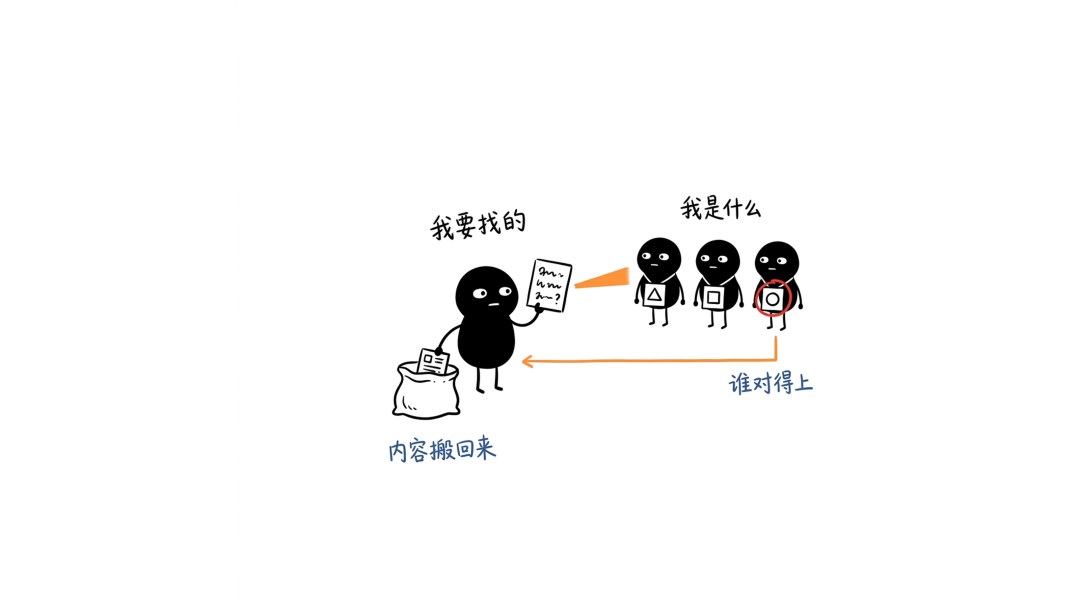
- Query(Q,查询):”我想找什么样的信息?”(代表当前词的检索意图)
- Key(K,键):”我是什么信息?”(代表其他词被检索的标签)
- Value(V,值):”我实际携带的内容是什么?”(代表包含的实际信息)
核心计算公式即 Vaswani 等人提出的经典缩放点积注意力(Scaled Dot-Product Attention):
1
2
| Attention(Q, K, V)
= softmax( Q · Kᵀ / √d_k ) · V
|
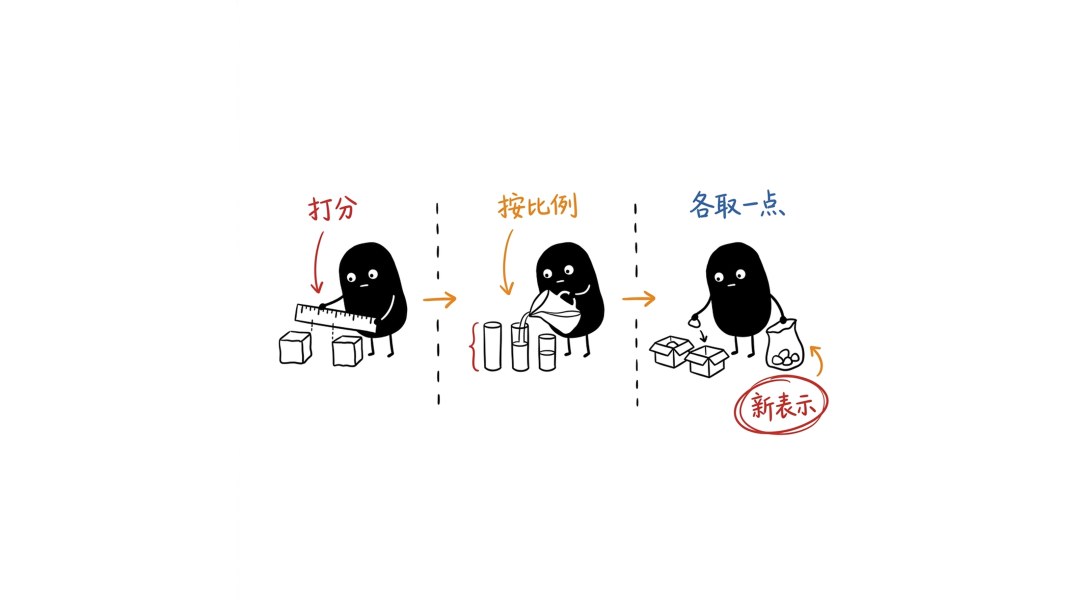
- Q · Kᵀ:通过内积计算任意两个词之间的相似度/关联强度。
- √d_k:缩放因子(Scaling Factor),防止维度 d_k 过大导致点积过大,使 softmax 梯度饱和进入平坦区。
- softmax(·):将相似度归一化为概率分布(每一行的权重和为 1)。
- × V:按权重对信息进行加权求和,得到融合了上下文的全新特征表示。
三、三步拆解:纯 NumPy 最小实验
我们用一个极小的离散数值用例,不依赖任何深度学习框架,完全透明地追踪每一步形状与数值变化。
. 准备输入数据与投影权重
假设输入序列长度为 N=3(比如 3 个词 “我 喜欢 苹果”),每个词的输入维度为 d_in=2,自注意力特征维度为 d_k=2:
1
2
3
4
5
6
7
8
9
10
11
12
13
| import numpy as np
X = np.array([
[1.0, 0.0],
[1.0, 1.0],
[0.1, 1.0]
])
W_Q = np.array([[1.0, 0.0], [0.0, 1.0]])
W_K = np.array([[1.0, 1.0], [1.0, 1.0]])
W_V = np.array([[1.0, 0.0], [1.0, 1.0]])
|
. 投影生成 Q、K、V
通过矩阵乘法(@)完成线性变换:
1
2
3
4
5
6
7
8
|
Q = X @ W_Q
K = X @ W_K
V = X @ W_V
print("Q =\n", Q)
print("K =\n", K)
print("V =\n", V)
|
. 计算注意力分数与加权求和
我们将经典公式拆解为三个微观步骤:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
d_k = K.shape[-1]
scores = (Q @ K.T) / np.sqrt(d_k)
def softmax(x, axis=-1):
e_x = np.exp(x - np.max(x, axis=axis, keepdims=True))
return e_x / np.sum(e_x, axis=axis, keepdims=True)
attn_weights = softmax(scores, axis=-1)
output = attn_weights @ V
print("--- 注意力权重矩阵 (每一行和为1) ---")
print(np.round(attn_weights, 4))
print("\n--- 最终输出上下文特征 (Output) ---")
print(np.round(output, 4))
|
四、进阶:用 PyTorch 封装标准自注意力层
在实际工业实现或模型训练中,权重矩阵是可学习参数,且需要支持批量输入 (batch_size, seq_len, embed_dim) 以及掩码(Mask):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
| import torch
import torch.nn as nn
import math
class SelfAttention(nn.Module):
def __init__(self, embed_dim):
super().__init__()
self.embed_dim = embed_dim
self.q_proj = nn.Linear(embed_dim, embed_dim, bias=False)
self.k_proj = nn.Linear(embed_dim, embed_dim, bias=False)
self.v_proj = nn.Linear(embed_dim, embed_dim, bias=False)
def forward(self, x, mask=None):
batch_size, seq_len, embed_dim = x.size()
Q = self.q_proj(x)
K = self.k_proj(x)
V = self.v_proj(x)
scores = torch.bmm(Q, K.transpose(1, 2)) / math.sqrt(embed_dim)
if mask is not None:
scores = scores.masked_fill(mask == 0, float('-inf'))
attn_weights = torch.softmax(scores, dim=-1)
context = torch.bmm(attn_weights, V)
return context, attn_weights
if __name__ == '__main__':
x_sample = torch.randn(2, 4, 16)
sa = SelfAttention(embed_dim=16)
out, weights = sa(x_sample)
print("PyTorch 输出形状:", out.shape)
print("注意力矩阵形状:", weights.shape)
|
五、关键踩坑点与避坑指南
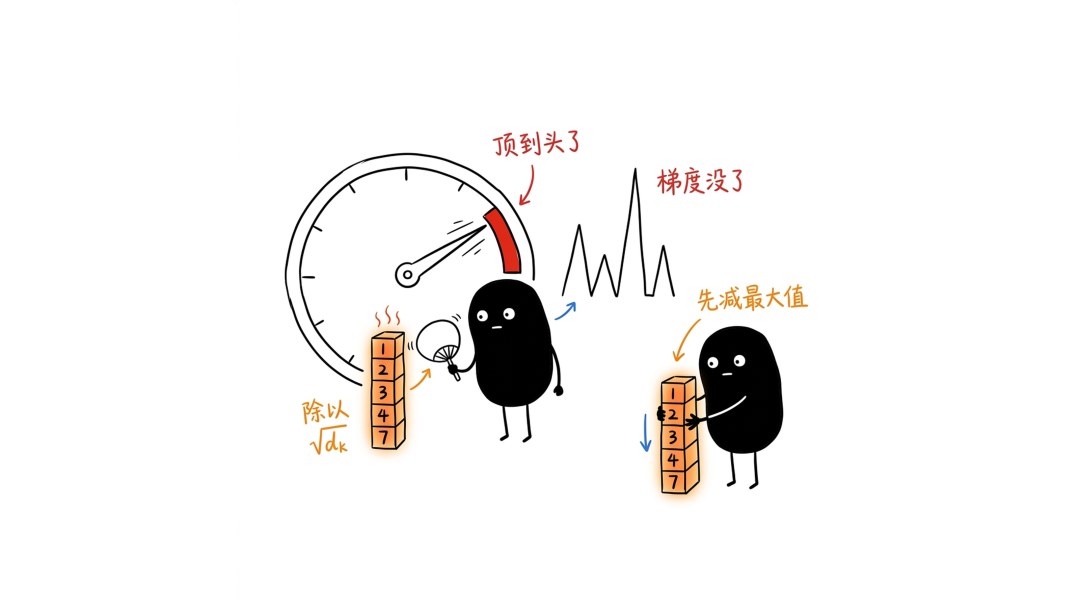
- 维度缩放 √d_k 绝不能少: 若没有缩放,当 d_k 很大时,点积内积的方差会变得很大,导致 softmax 输出极大值与极小值(接近 One-Hot 分布),反向传播时梯度几乎为 0。
- Softmax 数值稳定性: 手写实现时务必记得先减去行最大值(
x - np.max(x)),避免指数运算产生 inf 或 nan。
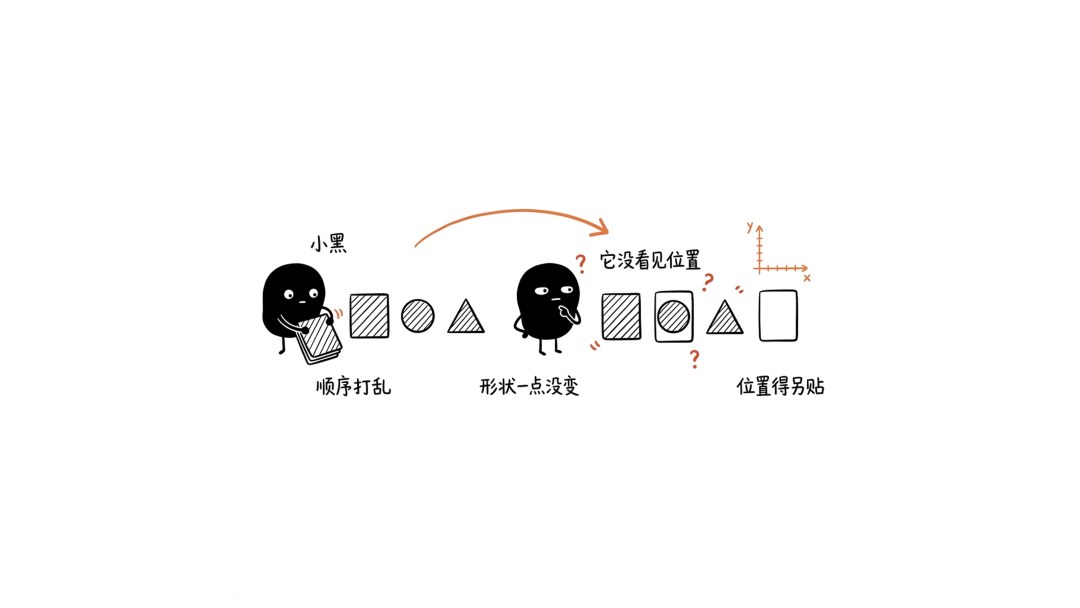
- 序列无序性(置换不变性): 纯 Self-Attention 对词的位置是没有感知的(打乱输入顺序,输出只是同步打乱)。因此在完整的 Transformer 中,必须在外层加上位置编码(Positional Encoding)。
结论
Q、K、V 不用背,把它当成一次检索就通了:拿自己的问题(Q)去比所有人的标签(K),谁对得上,就把谁的内容(V)按比例搬一点回来。真正要留心的只有两处,除以 √d_k 不能省,softmax 前先减最大值。想验证,把上面那段 NumPy 复制到本地跑一遍,改一下 X 里的数字,看注意力权重矩阵怎么变——比看三遍公式有用。